---
title: Java 并发面试一
date: 2020-06-04 13:51:00
order: 7
categories:
- Java
- JavaCore
- 面试
tags:
- Java
- JavaCore
- 面试
- 并发
permalink: /pages/37e2c2f3/
---
# Java 并发面试一
## 并发简介
### 【简单】并发和并行有什么区别?⭐⭐⭐
> - 什么是并发?
> - 什么是并行?
> - 并发和并行有什么区别?
并发和并行是最容易让新手费解的概念,那么如何理解二者呢?其最关键的差异在于:是否是**同时**发生:
- **并发指多个任务在同一时间段内交替执行**,以提高系统效率和资源利用率。
- **并行是指具备同时处理多个任务的能力**。
下面是我见过最生动的说明,摘自 [并发与并行的区别是什么?——知乎的高票答案](https://www.zhihu.com/question/33515481/answer/58849148)
- 你吃饭吃到一半,电话来了,你一直到吃完了以后才去接,这就说明你不支持并发也不支持并行。
- 你吃饭吃到一半,电话来了,你停了下来接了电话,接完后继续吃饭,这说明你支持并发。
- 你吃饭吃到一半,电话来了,你一边打电话一边吃饭,这说明你支持并行。
### 【简单】同步和异步有什么区别?⭐⭐⭐
> - 什么是同步?
> - 什么是异步?
> - 同步和异步有什么区别?
- **同步**指任务必须按顺序依次执行,等待当前任务完成才能继续;
- **异步**指任务可以独立执行,无需等待当前任务完成即可处理其他任务。
比喻:
- 同步就像是打电话:不挂电话,通话不会结束。
- 异步就像是发短信:发完短信后,就可以做其他事;当收到回复短信时,手机会通过铃声或振动来提醒。
### 【简单】阻塞和非阻塞有什么区别?⭐⭐⭐
> - 什么是阻塞?
> - 阻塞和非阻塞有什么区别?
阻塞和非阻塞关注的是程序在等待调用结果(消息,返回值)时的状态:
- **阻塞**指任务执行时必须等待某操作完成才能继续;
- **非阻塞**指任务执行时无需等待,可立即返回并执行其他操作。
比喻:
- 阻塞:排队等奶茶,不拿到不走;
- 非阻塞:点完奶茶去逛街,店员短信通知后再取。
### 【中等】进程、线程、协程、管程有什么区别?⭐⭐⭐
进程、线程、协程、管程对比:
| **概念** | **定义** | **特点** | **适用场景** |
| -------- | -------------------------------------------- | ------------------------------------------------------------- | -------------------------------------- |
| **进程** | **可视为一个正在运行的程序** | 独立内存空间
切换开销大
进程间通信(IPC)较复杂 | 需要高隔离性的任务(如浏览器多标签) |
| **线程** | **CPU 调度的基本单位**(属于进程) | 共享进程内存
切换开销较小
需同步(锁)避免竞态 | 高并发任务(如 Web 服务器处理请求) |
| **协程** | **用户态轻量级线程**(协作式调度) | 无内核切换开销
由程序员控制切换(`yield`)
单线程内并发 | I/O 密集型高并发(如爬虫、异步编程) |
| **管程** | **管理共享资源的同步机制**(如锁、条件变量) | 封装线程同步逻辑
避免手动操作锁(如 Java `synchronized`) | 多线程共享资源(如线程安全的数据结构) |
**小结**:
- **进程**:隔离性强但开销大。
- **线程**:CPU 调度的基本单位,共享内存但需同步。
- **协程**:用户态线程,高效但需主动让出控制权。
- **管程**:同步工具,简化多线程资源共享。
**进程和线程的差异**
- 一个程序至少有一个进程,一个进程至少有一个线程。
- 线程比进程划分更细,所以执行开销更小,并发性更高
- 进程是一个实体,拥有独立的资源;而同一个进程中的多个线程共享进程的资源。
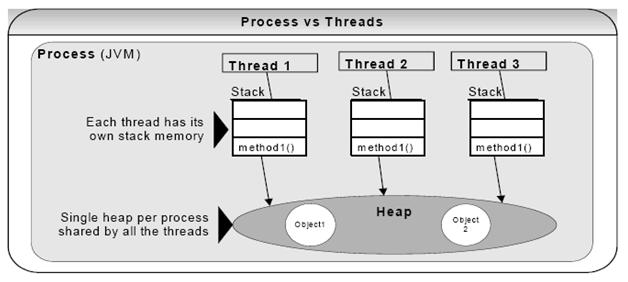
JVM 在单个进程中运行,JVM 中的线程共享属于该进程的堆。这就是为什么几个线程可以访问同一个对象。线程共享堆并拥有自己的堆栈空间。这是一个线程如何调用一个方法以及它的局部变量是如何保持线程安全的。但是堆不是线程安全的并且为了线程安全必须进行同步。
**线程和协程的差异**

### 【中等】Java 线程和操作系统的线程有什么区别?⭐⭐⭐
- **早期**:JVM 使用**用户线程(绿色线程)**,多个 Java 线程映射到一个 OS 线程(M:1)。
- **现代主流(HotSpot JVM)**:采用** 1:1 映射**,每个 Java 线程直接对应一个 OS 内核线程。
以下是 Java 线程与操作系统线程的区别对比表:
| **对比维度** | **Java 线程** | **操作系统线程** |
| ----------------- | --------------------------------------------------- | ---------------------------------------------- |
| **抽象层级** | JVM 层面的用户态抽象(现代 JVM 1:1 映射到 OS 线程) | 内核直接管理的原生线程(内核态) |
| **调度机制** | 依赖 OS 调度,但可通过协程(如虚拟线程)优化 | 完全由内核抢占式调度 |
| **创建/切换开销** | 高(需系统调用),但线程池可优化 | 高(上下文切换涉及用户态-内核态切换) |
| **并发模型** | 支持 1:1(默认)和 M:N(虚拟线程) | 仅 1:1,并发数受内核限制 |
| **平台依赖性** | 跨平台(JVM 统一行为,底层实现因 OS 而异) | 直接依赖 OS 和硬件特性(如线程优先级实现不同) |
| **同步机制** | 高级抽象(如`synchronized`,映射为 OS 原语) | 底层原语(如`pthread_mutex`) |
| **栈内存占用** | 默认 1MB(可调),虚拟线程仅 KB 级 | Linux 默认 8MB(不可跨线程共享) |
| **典型应用场景** | 通用并发编程,高并发推荐虚拟线程 | 直接系统编程,需精细控制线程行为的场景 |
### 【中等】Java 传统线程和虚拟线程有什么区别?⭐⭐⭐⭐
**虚拟线程(Virtual Threads,JDK 21 正式版,Project Loom)实现与 OS 线程 M:N 映射**,显著提升并发能力。
**Java 虚拟线程用更少的资源支持更高的并发**。
传统线程和虚拟线程对比:
| 维度 | 传统线程(OS 线程) | 虚拟线程 |
| :----------- | :------------------ | :------------------ |
| **并发数量** | 数千个 | 数百万个 |
| **内存开销** | 每个约 1MB | 每个约 1KB |
| **创建成本** | 高(内核操作) | 极低(用户态) |
| **阻塞代价** | 整个 OS 线程阻塞 | 仅虚拟线程挂起 |
| **调度方** | 操作系统内核 | JVM(用户态调度器) |
| **编程模型** | Thread API | 相同的 Thread API |
**载体线程(Carrier Thread)**
虚拟线程运行在**载体线程**(即 OS 内核线程)上。当虚拟线程执行阻塞操作时,JVM 会自动将虚拟线程从载体线程上**卸载(unmount)**,载体线程可以去执行其他虚拟线程。阻塞结束后,虚拟线程被**重新挂载(mount)**到载体线程上继续执行。
**虚拟线程 Pinning(载体线程针住问题)**
当虚拟线程在 `synchronized` 块或 `native` 方法中执行阻塞操作时,虚拟线程**无法从载体线程卸载**,导致载体线程被占用,这称为 **Pinning**。
```java
// 不良实践:synchronized + I/O 会导致 Pinning
synchronized (lock) {
httpClient.send(request, bodyHandler); // 虚拟线程被钉在载体线程上
}
// 最佳实践:用 ReentrantLock 替代 synchronized
private final ReentrantLock lock = new ReentrantLock();
lock.lock();
try {
httpClient.send(request, bodyHandler); // 虚拟线程可正常卸载
} finally {
lock.unlock();
}
```
**虚拟线程最佳实践**
- **适用场景**:I/O 密集型任务(HTTP 调用、数据库查询、文件读写)
- **不适用场景**:CPU 密集型计算任务(虚拟线程无法加速纯计算)
- **避免使用 ThreadLocal**:虚拟线程数量可达百万,ThreadLocal 内存开销巨大,推荐用 **Scoped Values**(JDK 21 预览)
- **避免 synchronized 包裹阻塞操作**:改用 `ReentrantLock` 避免 Pinning
- **不池化虚拟线程**:虚拟线程创建成本极低,用 `Thread.ofVirtual().start()` 直接创建即可
- **配合 ExecutorService**:`Executors.newVirtualThreadPerTaskExecutor()` 每个任务一个虚拟线程
```java
// JDK 21 推荐用法
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
IntStream.range(0, 100_000).forEach(i -> {
executor.submit(() -> {
Thread.sleep(Duration.ofSeconds(1)); // 不占用 OS 线程
return i;
});
});
}
```
::: info L4 扩展:跨语言对比——Go goroutine 与 Erlang Actor 模型
:::
**(一)Go goroutine 的 M:N 调度**
Go 语言的 goroutine 与 Java 虚拟线程在**调度理念上高度相似**,都是 M:N 用户态调度:
- **GOMAXPROCS 决定并行度**:在 Go 中,`GOMAXPROCS` 决定了同时运行 OS 线程的最大数量(默认等于 CPU 核数),这与 Java 虚拟线程的载体线程并行度 `jdk.virtualThreadScheduler.parallelism` 的设定理念一致——二者都是把用户态协程复用到固定数量的内核线程上。
- **G-M-P 调度模型**:Go 的调度器使用 G(goroutine)、M(machine/OS 线程)、P(processor/逻辑处理器)三层模型。P 在数量上受 `GOMAXPROCS` 限制,M 是实际的 OS 线程,G 在 P 的本地队列中排队。当一个 goroutine 发生阻塞系统调用时,P 会与当前 M 分离,与另一个 M 绑定继续调度其他 G——这与虚拟线程的 mount/unmount 机制的语义如出一辙。
- **抢占式调度 vs 协作式调度**:区别在于,Go 1.14 之前 goroutine 依赖协作式抢占(函数入口插入栈检查),而 Java 虚拟线程从第一天起就支持真正的抢占式调度(`Continuation.yield()` 可在任意安全点触发)。
**(二)Erlang Actor 模型对比**
Erlang 的并发模型走的是完全不同的一条路——**Actor 模型**:
| 维度 | Java 虚拟线程(结构化并发) | Erlang Actor 模型 |
| :----------- | :-------------------------------- | :------------------------------------------------- |
| **并发单元** | 轻量级线程(Thread) | 轻量级进程(Process) |
| **通信方式** | 共享内存(锁/原子类)+ 结构化并发 | 纯消息传递(不共享任何状态) |
| **调度** | JVM M:N 调度器(`ForkJoinPool`) | BEAM 虚拟机抢占式调度(每进程约 300 字节) |
| **隔离性** | 共享堆,需同步机制 | 完全内存隔离,无需锁 |
| **故障处理** | try-catch(同 JVM 进程内) | "Let it crash" 哲学 + Supervisors 树 |
| **适用场景** | I/O 密集型高并发、微服务后端 | 分布式、容错系统(如 RabbitMQ、WhatsApp、Discord) |
**关键认知**:Erlang 的 "不共享" 是其最大的闪光点,每个 Erlang 进程有独立的堆和 GC,崩溃不会影响其他进程。Java 虚拟线程仍然共享 JVM 堆,因此死锁、竞态条件等问题依然需要程序员自己处理。但好处是虚拟线程能直接复用 Java 生态中所有线程安全的数据结构和类库,而 Erlang 需要其专属的 OTP 框架。
### 【困难】虚拟线程的实现原理是什么?⭐⭐⭐⭐
**核心结论**:虚拟线程是 JVM 在**用户态**实现的轻量级线程,通过 **M:N 调度** 把海量虚拟线程复用到少量 OS 载体线程(Carrier Thread)上;其可挂起能力来自 **Continuation**——虚拟线程阻塞时,JVM 将它的栈帧从载体线程复制回堆内存(unmount),载体线程立即转去执行其他虚拟线程,阻塞结束后再把栈帧拷回并恢复执行(mount)。
**(1)M:N 调度模型**
- 平台线程(Platform Thread)是 OS 内核线程的 1:1 封装,调度完全依赖操作系统内核;虚拟线程则是 **M 个虚拟线程映射到 N 个载体线程**(M >> N),调度由 JVM 在用户态完成。
- 载体线程池默认是 `ForkJoinPool`,**并行度默认等于 CPU 核数**,可用 `-Djdk.virtualThreadScheduler.parallelism` 调整;载体线程数上限默认 256,由 `-Djdk.virtualThreadScheduler.maxPoolSize` 控制。
- 调度发生在用户态意味着:一次虚拟线程切换**没有系统调用、没有用户态-内核态上下文切换**。
**(2)Continuation:mount/unmount 的本质**
虚拟线程底层由 JDK 内部的 `Continuation` 支撑:
- **unmount(卸载)**:虚拟线程执行阻塞操作(网络/文件 I/O、`Thread.sleep`、`LockSupport.park`)时,JVM 调用 `Continuation.yield()`,把当前**栈帧链复制回堆内存**(Stack Chunk 对象),载体线程栈被清空,立刻可以运行下一个虚拟线程。
- **mount(挂载)**:阻塞结束后虚拟线程进入就绪队列,再次被调度时,JVM 把堆中保存的栈帧**拷回某个载体线程的栈**(不一定是原来那个),从 yield 点继续执行,仿佛从未中断。
- 由于栈保存在堆中,虚拟线程的内存占用是**按需伸缩的栈对象**(初始仅几百字节),而不是平台线程预先保留的约 1MB 线程栈。
**(3)定量对比**
| 维度 | 平台线程 | 虚拟线程 |
| :------------- | :------------------------ | :--------------------------- |
| 栈内存 | 固定约 1MB(`-Xss` 可调) | 初始几百字节,按需增长 |
| 创建成本 | 系统调用,微秒~十微秒级 | 纯堆对象分配,亚微秒级 |
| 上下文切换 | 内核态切换,约 1μs~5μs | 用户态栈拷贝,远小于内核切换 |
| 单机可支撑数量 | 数千(受内存与内核限制) | 百万级 |
| 阻塞代价 | OS 线程被占满直到阻塞结束 | unmount 后载体线程零占用 |
**(4)生产陷阱**
- **CPU 密集型无收益**:吞吐上限 = 载体线程数(≈CPU 核数),纯计算任务用虚拟线程不会更快,只多一层调度开销。
- **Pinning**:在 `synchronized` 块或 `native` 方法中阻塞时无法 unmount(JDK 24 JEP 491 已解决 `synchronized` 场景),排查与解决详见并发(三)Pinning 专项题。
- **ThreadLocal 失控**:百万级虚拟线程叠加 ThreadLocal 会带来巨大内存开销,应改用 ScopedValue,详见并发(二)专项题。
- **不要池化**:虚拟线程即用即抛,池化反而引入同步瓶颈,原因详见并发(三)专项题。
**(5)版本演进**
| 版本 | JEP | 里程碑 |
| :----- | :------ | :----------------------------------- |
| JDK 19 | JEP 425 | 虚拟线程首次预览 |
| JDK 20 | JEP 436 | 第二次预览 |
| JDK 21 | JEP 444 | 正式发布 |
| JDK 24 | JEP 491 | `synchronized` 不再 Pinning 载体线程 |
::: info L4 扩展:与 Go goroutine 实现差异(Continuation vs Stack Copying)
:::
**(一)两种截然不同的用户态栈管理策略**
Java 虚拟线程和 Go goroutine 虽然都是 M:N 用户态调度,但底层栈的管理机制有本质差异:
| 维度 | Java 虚拟线程(Continuation) | Go goroutine(Stack Copying) |
| :------------- | :------------------------------------------------------------- | :------------------------------------------------------------ |
| **栈存储位置** | 堆中的 Stack Chunk 对象 | 堆上分配的连续内存段 |
| **栈初始大小** | 约 200~400 字节 | 2KB(Go 1.4+) |
| **栈增长策略** | 按需分配新 Stack Chunk,形成**链表结构** | **栈拷贝(Copying)**:栈满时分配 2x 更大空间,拷贝旧栈内容 |
| **阻塞时行为** | yield 时栈帧保留在堆中(`Continuation.yield()`),不移动数据 | goroutine 阻塞时栈原地保留,调度器切换到另一个 goroutine 的栈 |
| **恢复时行为** | mount 时把堆中栈帧拷回载体线程栈(**不一定是原来的载体线程**) | 调度器挑一个 goroutine 恢复执行,栈已是完整连续的 |
| **GC 影响** | Stack Chunk 是普通 Java 对象,随 GC 回收 | Go 的并发 GC 需要对每个 goroutine 的栈进行栈扫描 |
| **核心优势** | 零拷贝 yield(仅切换指针),mount 时才拷贝 | 连续栈利于 CPU 缓存局部性,运行期内无碎片 |
**原理对比**:
- **Java 方案(Continuation on heap)**:虚拟线程的栈不是一段连续的栈内存,而是由多个 **Stack Chunk** 对象构成的链表。Stack Chunk 是普通的 Java 对象,分配在堆上,创建极快。阻塞时调用 `Continuation.yield()` 直接将当前运行时的栈帧保留在 Stack Chunk 中,不拷贝任何数据——mount 时才拷贝回载体线程。这牺牲了运行时的缓存局部性,但换来了极低的挂起开销。
- **Go 方案(Segmented Stack → Copying Stack)**:Go 早期使用分段栈(segmented stack),即多个不连续的内存段用链表链接,但发现 hot split 问题后彻底改为连续栈拷贝方案。每次栈满就分配 2x 大小的新连续内存,把旧栈数据拷过去,这虽然拷贝有开销,但运行时栈是连续的,CPU 缓存友好。
**(二)与 Project Loom 之前的 async/await 方案对比**
在虚拟线程出现之前,Java 生态的异步编程方案主要有:
| 方案 | 代表 | 编程模型 | 痛点 |
| :--------------------------- | :---------------------- | :----------------------------- | :------------------------------------------- |
| **Callback** | Netty、Vert.x | 回调嵌套 | "回调地狱",难以调试 |
| **CompletableFuture** | JDK 8+ | 链式组合 | 复杂业务逻辑链式调用冗长,异常处理分散 |
| **Reactive Streams** | RxJava、Project Reactor | 响应式流 | 学习曲线陡峭,堆栈追踪不可读 |
| **Kotlin Coroutines** | Kotlin | `suspend` 关键字,编译器状态机 | 与 Java 生态有两套心智模型,函数染色问题 |
| **虚拟线程(Project Loom)** | JDK 21+ | 同步代码写异步逻辑 | 最佳:无需函数染色,堆栈追踪完整,调试体验好 |
**Kotlin Coroutines 的函数染色问题**:一个 `suspend` 函数只能被另一个 `suspend` 函数或协程调用,这导致一旦在调用链的某个环节引入 `suspend`,整个上游调用链都必须标记为 `suspend`——这就是所谓的"函数染色"(function coloring)问题。Java 虚拟线程彻底消除了这个问题:`Thread.sleep()` 在虚拟线程中自动卸载载体线程,而调用方完全无感知,不需要任何 `suspend`/`await` 标记。
**本质差异**:async/await 方案是在**语言层面**将异步回调改写为看似同步的代码(编译器生成状态机),而虚拟线程是在**运行时层面**让真正的同步代码获得异步的性能。前者改变了开发模型,后者改变了执行模型。
### 【中等】单核 CPU 支持 Java 多线程吗?⭐⭐
**单核 CPU 可以支持 Java 多线程**,但多个线程**无法真正并行执行**,而是通过**时间片轮转(分时调度)**在单个 CPU 核心上交替运行,实现**并发(Concurrency)**而非**并行(Parallelism)**。
这里顺带提一下 Java 使用的线程调度方式。
操作系统主要通过两种线程调度方式来管理多线程的执行:
- **抢占式调度(Preemptive Scheduling)**:操作系统决定何时暂停当前正在运行的线程,并切换到另一个线程执行。这种切换通常是由系统时钟中断(时间片轮转)或其他高优先级事件(如 I/O 操作完成)触发的。这种方式存在上下文切换开销,但公平性和 CPU 资源利用率较好,不易阻塞。
- **协同式调度(Cooperative Scheduling)**:线程执行完毕后,主动通知系统切换到另一个线程。这种方式可以减少上下文切换带来的性能开销,但公平性较差,容易阻塞。
Java 使用的线程调度是抢占式的。也就是说,JVM 本身不负责线程的调度,而是将线程的调度委托给操作系统。操作系统通常会基于线程优先级和时间片来调度线程的执行,高优先级的线程通常获得 CPU 时间片的机会更多。
### 【简单】并发一定比串行更快吗?⭐⭐
**并发不一定比串行更快**!关键看场景:
**并发更快的情况**
- **多核 CPU**:真正并行执行计算任务
- **I/O 密集型**:网络/磁盘操作时,CPU 可切换做其他事
**串行更快的情况**
- **单核 CPU**:线程切换反而增加开销
- **高竞争场景**:锁争用导致线程空等
- **简单任务**:并发管理开销超过收益
**黄金法则**
- I/O 多用并发,计算多用多核
- 避免无脑加线程,合理控制并发度
### 【简单】什么是并发安全?有哪些线程不安全的情况?⭐⭐⭐
::: info 什么是并发安全?
:::
并发最重要的问题是并发安全问题。所谓**并发安全**,是指保证程序的正确性,使得并发处理结果符合预期。
并发安全需要保证几个基本特性:
- **可见性** - 是一个线程修改了某个共享变量,其状态能够立即被其他线程知晓,通常被解释为将线程本地状态反映到主内存上,`volatile` 就是负责保证可见性的。
- **原子性** - 简单说就是相关操作不会中途被其他线程干扰,一般通过同步机制(加锁:`sychronized`、`Lock`)实现。
- **有序性** - 是保证线程内串行语义,避免指令重排等。
::: info 有哪些线程不安全的情况?
:::
- **竞态条件**:多线程同时修改共享变量(如 `count++`)
- **非原子操作**:多步骤操作被中断(如 `if(x==null) x=new Object()`)
- **可见性问题**:线程 A 的修改对线程 B 不可见
- **死锁**:多个线程互相持有对方需要的锁
- **资源泄漏**:线程未释放资源(如连接、文件)
::: info 线程不安全有哪些解决办法?
:::
- 同步:`synchronized`、`Lock`
- 原子类:`AtomicInteger`
- 不可变对象:`final`
- 并发容器:`ConcurrentHashMap`
> 核心:减少共享数据,合理加锁
### 【中等】为什么会有并发安全问题?⭐⭐⭐
**(1)缓存导致的可见性问题**
一个线程对共享变量的修改,另外一个线程能够立刻看到,称为 **可见性**。
在单核时代,所有的线程都是在一颗 CPU 上执行,CPU 缓存与内存的数据一致性容易解决。

多核时代,每颗 CPU 都有自己的缓存,这时 CPU 缓存与内存的数据一致性就没那么容易解决了,当多个线程在不同的 CPU 上执行时,这些线程操作的是不同的 CPU 缓存。

**(2)线程切换带来的原子性问题**
Java 的并发也是基于任务切换。Java 中,即使是一条语句,也可能需要执行多条 CPU 指令。**一个或者多个操作在 CPU 执行的过程中不被中断的特性称为原子性**。
CPU 能保证的原子操作是 CPU 指令级别的,而不是高级语言的操作符。违背直觉的是,高级语言里一条语句往往需要多条 CPU 指令完成,例如上面代码中的`count += 1`,至少需要三条 CPU 指令。
- 指令 1:首先,需要把变量 count 从内存加载到 CPU 的寄存器;
- 指令 2:之后,在寄存器中执行+1 操作;
- 指令 3:最后,将结果写入内存(缓存机制导致可能写入的是 CPU 缓存而不是内存)。
因此,执行 `count += 1` 不是原子操作。

**(3)编译优化带来的有序性问题**
有序性指的是程序按照代码的先后顺序执行。编译器为了优化性能,有时候会改变程序中语句的先后顺序,例如程序中:`a=6; b=7;` 编译器优化后可能变成 `b=7; a=6;`,在这个例子中,编译器调整了语句的顺序,但是不影响程序的最终结果。不过有时候编译器及解释器的优化可能导致意想不到的 Bug。
### 【中等】哪些场景需要额外注意并发安全问题?⭐⭐
**通用原则**:最小化共享资源,优先用线程安全类,控制锁粒度,避免死锁,事后工具验证。
- **共享可变数据**:多线程读写普通变量 / 非安全集合(如 `ArrayList`)→ 用原子类(AtomicXXX)、线程安全容器(`ConcurrentHashMap`)或锁(`synchronized` / `Lock`)。
- **线程时序协作**:需按顺序执行或等待资源(如 A 初始化后 B 读取)→ 用 `wait` / `notify`、`Condition`,或工具类(`CountDownLatch`)、阻塞队列。
- **单例 / 静态容器**:懒汉单例、静态变量并发访问→ 单例用双重检查锁 + volatile / 枚举,静态容器用并发安全容器。
- **数据库 / 外部资源**:多线程操作同数据(如扣库存)→ 数据库用悲观 / 乐观锁,分布式场景用 Redis 锁,业务层保证 “查 - 改” 原子性。
- **线程池与 ThreadLocal**:任务共享资源、`ThreadLocal` 未清理→ 任务内同步,ThreadLocal 在 finally 中 remove。
- **原子操作拆分**:`if-check-and-then` 操作(如 `if (count<10) count++`)→ 用原子类 compareAndSet 或锁包裹整体操作。
### 【困难】什么是死锁?如何发现死锁?如何避免死锁?⭐⭐⭐⭐⭐
::: info 什么是死锁?
:::
**死锁**:**一组互相竞争资源的线程因互相等待,导致“永久”阻塞的现象**。
产生死锁的四个必要条件:
- **互斥**:该资源任意一个时刻只由一个线程占用。
- **占有并等待**:一个线程因请求资源而阻塞时,对已获得的资源保持不放。
- **不可抢占**:线程已获得的资源在未使用完之前不能被其他线程强行剥夺,只有自己使用完毕后才释放资源。
- **循环等待**:若干线程之间形成一种头尾相接的循环等待资源关系。

【示例】必然死锁的示例
```java
import java.util.concurrent.CountDownLatch;
public class DeadlockWithCountDownLatch {
private static final Object lock1 = new Object();
private static final Object lock2 = new Object();
private static final CountDownLatch latch1 = new CountDownLatch(1);
private static final CountDownLatch latch2 = new CountDownLatch(1);
private static final CountDownLatch startLatch = new CountDownLatch(1);
public static void main(String[] args) throws InterruptedException {
Thread t1 = new Thread(() -> {
try {
startLatch.await(); // 等待统一开始
synchronized (lock1) {
System.out.println("T1 持有 lock1");
latch1.countDown(); // 通知 T2:我已持有 lock1
latch2.await(); // 等待 T2 持有 lock2
System.out.println("T1 尝试获取 lock2");
synchronized (lock2) { // 此时 lock2 被 T2 持有,阻塞
System.out.println("T1 获取 lock2");
}
}
} catch (InterruptedException e) {}
});
Thread t2 = new Thread(() -> {
try {
startLatch.await();
synchronized (lock2) {
System.out.println("T2 持有 lock2");
latch2.countDown(); // 通知 T1:我已持有 lock2
latch1.await(); // 等待 T1 持有 lock1(此时 latch1 已减,通过)
System.out.println("T2 尝试获取 lock1");
synchronized (lock1) { // lock1 被 T1 持有,阻塞
System.out.println("T2 获取 lock1");
}
}
} catch (InterruptedException e) {}
});
t1.start();
t2.start();
startLatch.countDown(); // 同时启动两个线程
Thread.sleep(3000); // 观察死锁
System.out.println("主线程:疑似死锁发生");
}
}
```
::: info 如何发现死锁?
:::
(1)使用 `jstack` 工具
- 运行程序后,执行命令:
```shell
jstack # PID 是 Java 进程 ID
```
- 如果存在死锁,输出会显示 `Found one Java-level deadlock`,并列出死锁的线程和资源。
(2)使用 `ThreadMXBean` 检测(代码方式)
```java
import java.lang.management.ManagementFactory;
import java.lang.management.ThreadMXBean;
public class DeadlockDetector {
public static void main(String[] args) {
ThreadMXBean threadMXBean = ManagementFactory.getThreadMXBean();
long[] deadlockedThreads = threadMXBean.findDeadlockedThreads(); // 检测死锁线程
if (deadlockedThreads != null) {
System.out.println("发现死锁!涉及线程:");
for (long threadId : deadlockedThreads) {
System.out.println(threadId);
}
} else {
System.out.println("无死锁。");
}
}
}
```
输出示例:
```
发现死锁!涉及线程:
12345
67890
```
(3)使用 VisualVM 或 JConsole(可视化工具)
连接 Java 进程后,查看**线程**选项卡,死锁会被明确标记。
::: info 如何避免死锁?
:::
**如何预防死锁?** 破坏死锁的产生的必要条件即可:
- **互斥**:难以避免
- **占有并等待**:一次性申请所有资源
- **不可抢占**:超时释放锁
- **循环等待**:按序申请资源
**如何避免死锁?**
避免死锁就是在资源分配时,借助于算法(比如银行家算法)对资源分配进行计算评估,使其进入安全状态。
**安全状态** 指的是系统能够按照某种线程推进顺序(P1、P2、P3……Pn)来为每个线程分配所需资源,直到满足每个线程对资源的最大需求,使每个线程都可顺利完成。称 `` 序列为安全序列。
**生产环境最常用的两种编码手段**
(1)**按序加锁**(破坏「循环等待」,最常用):所有线程按固定顺序获取锁。以银行转账为例,按账户 ID 排序后再加锁,转账双方无论谁先发起都不会形成环:
```java
public void transfer(Account from, Account to, BigDecimal amount) {
// 按账户 ID 排序,保证所有线程加锁顺序全局一致
Account first = from.getId() < to.getId() ? from : to;
Account second = (first == from) ? to : from;
synchronized (first) {
synchronized (second) {
if (from.getBalance().compareTo(amount) >= 0) {
from.withdraw(amount);
to.deposit(amount);
}
}
}
}
```
(2)**`tryLock` 超时放弃**(破坏「不可抢占」):拿不到第二把锁就释放已持有的锁,随机退避后重试(随机退避同时可避免活锁):
```java
while (true) {
if (lockA.tryLock()) {
try {
if (lockB.tryLock(100, TimeUnit.MILLISECONDS)) {
try {
doTransfer();
return;
} finally {
lockB.unlock();
}
}
} finally {
lockA.unlock(); // 拿不到 lockB,主动释放 lockA
}
}
Thread.sleep(ThreadLocalRandom.current().nextInt(50)); // 随机退避
}
```
(3)**线上巡检**:生产系统可用定时任务周期调用 `ThreadMXBean.findDeadlockedThreads()`,发现死锁立即告警并输出线程 Dump;也可开启 JFR 的 `jdk.ThreadDump` 事件做周期快照。
::: info L4 扩展:跨语言死锁检测与消除机制对比
:::
**(一)Go Race Detector 对比 Java 死锁检测工具**
Go 语言提供了内置的竞态检测器(Race Detector),与 Java 的死锁检测形成了鲜明对比:
| 维度 | Go Race Detector (`go run -race`) | Java 死锁检测 (`jstack` / `ThreadMXBean`) |
| :----------- | :--------------------------------------------------------------------------------------- | :---------------------------------------------------------------------------------- |
| **检测对象** | **数据竞态**(data race):两个 goroutine 无同步地并发读写同一内存 | **死锁**(deadlock):线程因锁循环依赖而永久阻塞 |
| **实现原理** | 编译期插桩 + 运行时 Thread Sanitizer(TSan)算法,追踪每次内存访问的 happens-before 关系 | 运行时分析等待图,通过 JVM TI / JMX 检测锁的循环依赖 |
| **检测时机** | 运行时,当竞态实际发生时才会报告(不是静态分析) | 可主动轮询 `findDeadlockedThreads()` 或被动分析线程 Dump |
| **性能开销** | 内存增加 5~~10x,CPU 慢 2~~20x(仅限测试环境) | `ThreadMXBean` 开销极小,几乎可生产环境实时检测 |
| **覆盖范围** | 覆盖所有内存访问(包括无锁算法、channel 操作等),但**不能检测死锁本身** | 仅检测 JVM 管理的锁(`synchronized` / `java.util.concurrent` 锁),不能检测数据竞态 |
| **工程实践** | `go test -race` 是 CI 流水线必备环节,Google 内部所有 Go 代码均要求 race-free | 生产系统通过定时任务 `findDeadlockedThreads()` + JFR 实时监控锁竞争 |
**关键差异**:Go 的 Race Detector 检测的是**数据竞态**(并发访问的正确性问题),而 Java 的 `findDeadlockedThreads()` 检测的是**死锁**(线程活跃性问题)。二者解决的问题不同,但同样重要。Java 缺少内置的轻量级数据竞态检测器(虽然有 `jcstress` 并发测试框架,但不如 `-race` 使用便捷)。
**(二)Rust 的所有权系统——编译期消除死锁**
Rust 语言在最底层就消除了绝大部分并发问题的可能性,这得益于其三大核心机制:
**1. 所有权(Ownership)+ 借用检查(Borrow Checker)——编译期消除数据竞态**
Rust 的类型系统在编译期静态保证:
- 任意时刻,要么只有一个可变引用(`&mut T`),要么有多个不可变引用(`&T`),二者不可共存。
- 编译期借用检查器(Borrow Checker)对每条语句验证引用生命周期,违反规则直接编译失败。
这意味着 Rust 程序的**数据竞态在编译期就被杜绝**——不像 Java 需要通过 `synchronized`、`volatile` 或原子类来在运行时保护,也不像 Go 需要 `-race` 来事后检测。
**2. `Send` 和 `Sync` trait——编译期保证线程安全边界**
- `Send`:标记类型可以安全地将所有权转移到另一个线程(几乎所有 Rust 类型默认实现 `Send`,但 `Rc` 等非线程安全类型不会实现)。
- `Sync`:标记类型可以安全地在多个线程间共享引用(`Arc` 实现了 `Sync`,而 `Rc` 没有)。
编译器会在编译期检查:如果某个类型没有实现 `Send`/`Sync`,试图跨线程传递/共享它就是编译错误。这比 Java 依赖程序员的 `synchronized` 判断要安全得多——Java 中把一个非线程安全的 `ArrayList` 传给多个线程是**编译通过但运行出错**的,而在 Rust 中类似行为(把 `Rc>` 传给另一个线程)直接**编译失败**。
**3. 死锁呢?——Rust 并非万能**
需要澄清一个重要事实:**Rust 的借用检查器无法消除死锁**。死锁是运行时资源依赖问题(A 等 B、B 等 A),不是内存安全问题。Rust 程序依然可能写出典型的 `mutex1.lock()` → `mutex2.lock()` 的死锁代码。
但 Rust 社区形成了强约束实践:
- **优先使用 Channel 通信**(`std::sync::mpsc`),遵循 "Do not communicate by sharing memory; instead, share memory by communicating" 哲学。
- 当必须使用锁时,**使用 `Mutex` 包裹数据而非保护代码块**,锁在离开作用域时自动释放(RAII),避免了 Java 中忘记 `unlock()` 的问题。
- 使用 `parking_lot` 等第三方库的 `Mutex` 支持 `try_lock_for` 超时机制。
| 对比维度 | Java | Go | Rust |
| :--------------- | :----------------------------------- | :--------------------------------- | :--------------------------------- |
| **数据竞态检测** | 无内置(需 `jcstress`) | 内置 `-race`(TSan) | 编译期杜绝(Borrow Checker) |
| **死锁检测** | `findDeadlockedThreads()` / `jstack` | 运行时死锁检测器(goroutine Dump) | 无(编译期不保证,运行时需第三方) |
| **死锁防止** | 编码规范 + tryLock 超时 | Channel 通信优先 + `sync.Mutex` | RAII 自动释放锁 + Channel 优先 |
| **并发安全哲学** | 程序员自行保证 | 工具辅助检测 | 编译器静态保证 |
### 【中等】什么是活锁?如何避免活锁?⭐⭐
::: info 什么是活锁?
:::
**活锁**是指多个线程/进程在执行时,虽然都在运行(不阻塞),但通过相互谦让或重复响应对方的状态变化,导致**谁都无法向前推进**的状态。
想象这样一个例子:两个人在狭窄的走廊里相遇,二者都很礼貌,试图移到旁边让对方先通过。但是他们最终在没有取得任何进展的情况下左右摇摆,因为他们都在同一时间向相同的方向移动。

如图所示:两个线程想要通过一个 Worker 对象访问共享公共资源的情况,但是当他们看到另一个 Worker(在另一个线程上调用)也是“活动的”时,它们会尝试将该资源交给其他工作者并等待为它完成。如果最初我们让两名工作人员都活跃起来,他们将会面临活锁问题。
::: info 如何避免活锁?
:::
解决“**活锁**”的方案很简单,谦让时,尝试等待一个随机的时间就可以了。由于等待的时间是随机的,所以同时相撞后再次相撞的概率就很低了。“等待一个随机时间”的方案虽然很简单,却非常有效,Raft 这样知名的分布式一致性算法中也用到了它。
### 【中等】什么是饥饿问题?如何避免饥饿?⭐⭐
::: info 什么是饥饿问题?
:::
**定义**:某些线程由于**长期无法获取所需资源**(如 CPU 时间、锁、I/O 等),导致**任务无法执行或执行缓慢**。
**与死锁/活锁的区别**:
- **死锁**:所有相关线程都被阻塞,无法继续。
- **活锁**:线程在运行,但无法取得进展。
- **饥饿**:部分线程能正常运行,但某些线程长期得不到资源。
**饥饿的常见原因**
| **原因** | **示例** |
| -------------------- | ------------------------------------------------------ |
| **线程优先级不合理** | 高优先级线程总是抢占 CPU,低优先级线程长期得不到执行。 |
| **锁竞争不公平** | 某些线程总是抢不到锁(如`synchronized`是非公平锁)。 |
| **资源分配不均** | 线程池任务调度不合理,某些任务被长时间搁置。 |
| **I/O 或网络阻塞** | 某些线程因 I/O 操作被阻塞,而其他线程持续占用 CPU。 |
::: info 如何避免饥饿?
:::
**(1)使用公平锁(Fair Lock)**
- **`ReentrantLock` 支持公平策略**,避免某些线程长期抢不到锁。
```java
ReentrantLock fairLock = new ReentrantLock(true); // true 表示公平锁
```
- **`synchronized` 是非公平的**,无法直接设置公平性。
**(2)合理设置线程优先级**
- 避免滥用高优先级,尽量让所有线程有机会执行。
- Java 线程优先级(1~10,默认 5):
```java
thread.setPriority(Thread.NORM_PRIORITY); // 5
```
**(3)避免长时间占用资源**
- 减少锁的持有时间,尽量只在必要时加锁。
- 使用 `tryLock()` 设置超时,防止无限等待:
```java
if (lock.tryLock(100, TimeUnit.MILLISECONDS)) {
try { /* 临界区 */ }
finally { lock.unlock(); }
}
```
**(4)优化线程池任务调度**
- 使用 `newFixedThreadPool` 或 `newCachedThreadPool` 时,结合 `BlockingQueue` 避免任务堆积。
- 可改用 `ForkJoinPool` 进行任务拆分,提高公平性。
**(5)监控与调整**
- 使用 **VisualVM、JConsole** 等工具观察线程状态,发现长期阻塞的线程。
- 结合日志分析,优化资源分配策略。
### 【简单】简单介绍一下 Java 并发编程?⭐⭐
并发编程可以抽象成三个核心问题:分工、同步、互斥。
- **分工** - 是指如何高效地拆解任务并分配给线程。
- **同步** - 是指线程之间如何协作。
- **互斥** - 是指保证同一时刻只允许一个线程访问共享资源。

Java 的 `java.util.concurrent` 包(简称 J.U.C)中提供了大量并发工具类,是 Java 并发能力的主要体现(注意,不是全部,有部分并发能力的支持在其他包中)。从功能上,大致可以分为:
- **原子类** - 如:`AtomicInteger`、`AtomicIntegerArray`、`AtomicReference`、`AtomicStampedReference` 等。
- **锁** - 如:`ReentrantLock`、`ReentrantReadWriteLock` 等。
- **并发容器** - 如:`ConcurrentHashMap`、`CopyOnWriteArrayList`、`CopyOnWriteArraySet` 等。
- **阻塞队列** - 如:`ArrayBlockingQueue`、`LinkedBlockingQueue` 等。
- **非阻塞队列** - 如: `ConcurrentLinkedQueue` 、`LinkedTransferQueue` 等。
- **线程池** - 如:`ThreadPoolExecutor`、`Executors` 等。
J.U.C 包中的工具类是基于 `synchronized`、`volatile`、`CAS`、`ThreadLocal` 这样的并发核心机制打造的。所以,要想深入理解 J.U.C 工具类的特性、为什么具有这样那样的特性,就必须先理解这些核心机制。
## Java 内存模型
### 【中等】什么是 Java 内存模型?⭐⭐⭐⭐
**Java Memory Model (JMM)** 是 Java 规范定义的一套**多线程内存访问规则**,用于解决并发编程中的**可见性、原子性、有序性**问题。目的是让 Java 程序在不同硬件和操作系统上都能正确执行并发操作。
**CPU、内存、I/O 设备存在很大的速度差异** - CPU 远快于内存,内存远快于 I/O 设备。
为了合理利用 CPU 的高性能,平衡这三者的速度差异,计算机体系机构、操作系统、编译程序都做出了贡献,主要体现为:
- **CPU 增加了缓存**,以均衡与 CPU 内存的速度差异;
- **编译程序优化指令执行次序**,使得缓存能够得到更加合理地利用。
- **操作系统增加了进程、线程**,以分时复用 CPU,进而均衡 CPU 与 I/O 的速度差异;
**缓存一致性**
**缓存**导致的可见性问题,**编译优化**带来的有序性问题,**线程切换**带来的原子性问题。
为了解决缓存一致性问题,**需要各个处理器访问缓存时都遵循一些协议,在读写时要根据协议来进行操作**。

**指令重排序**
为了使缓存得到更加合理地使用,计算机在执行程序代码的时候,会对指令进行重排序。常见的指令重排序有下面 2 种情况:
- **编译器优化重排**:编译器在不改变单线程语义的前提下调整语句顺序。
- **指令并行重排**:处理器利用指令级并行技术(ILP)调整指令执行顺序(无数据依赖时)。
Java 源代码会经历 **编译器优化重排 —> 指令并行重排 —> 内存系统重排** 的过程,最终才变成操作系统可执行的指令序列。指令重排序**可以保证串行语义一致,但是没有义务保证多线程间的语义也一致 ,所以在多线程下,指令重排序可能会导致一些问题。**
解决方案:
- **编译器**:禁止特定类型的编译器重排序。
- **处理器**:通过插入**内存屏障(Memory Barrier/Fence)**禁止特定处理器重排序。
> 👉 扩展阅读:[全面理解 Java 内存模型](https://blog.csdn.net/suifeng3051/article/details/52611310)
::: info L4 扩展:跨语言内存模型对比——C++11 与硬件内存序
:::
**(一)C++11 Memory Model:与 JMM 的"孪生兄弟"**
C++11 在 2011 年正式引入了多线程内存模型(`std::memory_order`),与 JMM(JSR-133,2004 年修订)几乎诞生于同一时代,二者有惊人的相似性:
| 维度 | Java 内存模型 (JMM) | C++11 Memory Model | 相似点 |
| :--------------------- | :----------------------------------------------------------------------------- | :-------------------------------------------------------------------------------- | :---------------------------------------- |
| **核心目标** | 屏蔽硬件差异,定义跨平台的线程间内存访问规则 | 与 JMM 完全相同:定义跨硬件平台的并发语义 | 都是"抽象机"模型,不直接描述硬件行为 |
| **happens-before** | 偏序关系,定义操作间的可见性约束 | `happens-before` 概念几乎完全一致(受 Lamport 论文启发) | 同源:都来自 Lamport 1978 年论文 |
| **原子操作与内存序** | 无直接暴露;`volatile` 提供 acquire/release 语义,CAS 提供全序 | 明确的 6 种顺序:`relaxed`、`consume`、`acquire`、`release`、`acq_rel`、`seq_cst` | C++11 粒度更细,Java 更简化 |
| **顺序一致性** | JMM 默认不保证顺序一致性(允许重排序),`volatile` + `synchronized` 组合可近似 | `seq_cst` 是默认内存序(C++ 原子操作默认最严格) | 默认策略相反:C++ 偏好安全,Java 偏好性能 |
| **final 字段安全发布** | JMM 特殊规则:构造函数中 final 字段初始化 + 安全发布 = 对其他线程可见 | 没有对等概念,需手动用 `atomic` + `release/acquire` 保证 | Java 特有:面向 JVM 的简化 |
**为什么说它们是"同一个时代的孩子"?** 在 2004~2011 年间,x86 多核处理器大规模普及,Java、C++ 两个语言社区同时面临同一个问题:如何在不触碰硬件的情况下定义并发语义?JMM 的 JSR-133(2004)和 C++11 Memory Model(2011)都是这个 hardware concurrency revolution 时代的产物。它们的核心策略一致——通过 happens-before 关系在抽象机层面定义操作间的约束,而非直接绑定某个具体的 CPU 架构。
**(二)x86 TSO vs ARM Weak Memory Model:硬件差异的根本来源**
Java 和 C++ 的抽象内存模型之所以存在,本质上是**不同 CPU 架构的内存模型差异巨大**:
**x86 TSO(Total Store Order——全序存储模型)**
x86 架构(Intel/AMD)是典型的**强内存模型**:
- **Store→Store**:写操作对其他核心按 FIFO 顺序可见(写不会被重排序)。
- **Load→Load**:读操作对其他核心也按序可见(读不会被重排序)。
- **但 Store→Load 可重排序**:`Store X = 1; Load Y;` 可能被重排为 `Load Y; Store X = 1;`——这是 x86 唯一的重排序类型,也是为什么 `volatile` 写后需要 `StoreLoad` 屏障(`mfence` 或 `lock` 前缀指令)。
在 x86 上,因为除 StoreLoad 外所有重排序都被硬件禁止,JMM 的 `StoreStore`、`LoadLoad`、`LoadStore` 屏障实际上是**零成本**的——CPU 硬件本身就保证了这些顺序。只有 `StoreLoad` 需要真实的屏障指令(`mfence` / `lock`)。
**ARM/POWER Weak Memory Model(弱内存模型)**
ARM 和 POWER 架构是典型的**弱内存模型**:
- **几乎所有乱序都可能发生**:Store→Store、Load→Load、Store→Load、Load→Store 都可能被处理器重排序。
- **需要显式屏障**:必须通过 `dmb`(Data Memory Barrier,ARM)、`sync`(POWER)等显式指令来强制顺序。
- Java `volatile` 在 ARM 上的成本远高于 x86——因为 `StoreStore`、`LoadLoad`、`LoadStore` 都需要真实的屏障指令。
| 维度 | x86 TSO | ARM Weak Memory |
| :------------------ | :--------------------------------------------- | :---------------------- |
| **写-写重排序** | ❌ 不允许 | ✔️ 允许 |
| **读-读重排序** | ❌ 不允许 | ✔️ 允许 |
| **写-读重排序** | ✔️ 允许(唯一) | ✔️ 允许 |
| **读-写重排序** | ❌ 不允许 | ✔️ 允许 |
| **volatile 写成本** | 低(仅 StoreLoad 屏障 = `lock` 前缀 ~20 周期) | 高(需多个 `dmb` 屏障) |
| **volatile 读成本** | 几乎无开销(LoadLoad/LoadStore = NOP) | 需 `dmb` 屏障 |
**关键启示**:JMM 和 C++11 Memory Model 都必须为"最坏情况"(ARM/POWER)定义语义。在 x86 上看起来"免费"的 volatile 操作,到了 ARM 上成本可能显著增加。这就是抽象内存模型的价值所在——程序员无需关心底层是 x86 还是 ARM,JMM 保证 volatile 在所有平台上语义一致,代价由 JVM 在屏障插入时根据不同架构动态优化。
> 参考:Intel® 64 and IA-32 Architectures Software Developer's Manual, Volume 3A, Chapter 8.2 "Memory Ordering";ARM Architecture Reference Manual, Chapter B2.2 "Memory Ordering"。
### 【困难】什么是 Happens-Before 规则?有什么用?⭐⭐⭐
JMM 为程序中所有的操作定义了一个偏序关系,称之为 **`先行发生原则(Happens-Before)`**。**Happens-Before 是 JMM 的核心规则,用于约束指令重排序和保证多线程可见性。**
**Happens-Before** 非常重要,它是判断数据是否存在竞争、线程是否安全的主要依据,依靠这个原则,我们可以通过几条规则一揽子地解决并发环境下两个操作间是否可能存在冲突的所有问题。
1. **程序顺序规则**:单线程内代码顺序执行(但不影响多线程重排序)。
2. **`volatile` 规则**:**`volatile` 写** Happens-Before **后续的 `volatile` 读**。**volatile 保证可见性 + 禁止指令重排序**。
3. **锁规则**:**解锁** Happens-Before **后续的加锁**(如 `synchronized`、`ReentrantLock`)。
4. **线程启动规则**:**`Thread.start()`** Happens-Before **线程内的所有操作**。
5. **线程终止规则**:**线程中的所有操作** Happens-Before **`Thread.join()` 完成**。
6. **线程中断规则**:**`Thread.interrupt()`** Happens-Before **被中断线程检测到中断(`isInterrupted()` 或 `InterruptedException`)**。
7. **对象终结规则**:**对象的构造函数执行结束** Happens-Before **`finalize()` 方法被调用**。
8. **传递性**:若 A → B 且 B → C,则 A → C。
> 1978 年,Lamport 在论文 [**Time, Clocks, and the Ordering of Events in a Distributed System**](https://lamport.azurewebsites.net/pubs/time-clocks.pdf) ([**译文**](https://cloud.tencent.com/developer/article/1163428),[**解读**](https://zhuanlan.zhihu.com/p/56146800) )中第一次提出了 Happens-Before,阐述了偏序关系(partial ordering)、逻辑时钟(Logical Clocks)概念,提出解决分布式系统中区分事件发生的时序问题的方法。Happens-Before 的语义是一种因果关系:如果 A 事件是导致 B 事件的起因,那么 A 事件一定是先于(Happens-Before)B 事件发生的。
### 【困难】什么是 Java 内存屏障?有什么用?⭐⭐⭐
内存屏障(Memory Barrier/Fence)是 JMM 的底层机制,通过 **限制重排序** 和 **强制缓存同步**,实现多线程程序的 **可见性** 和 **有序性**。
- **禁止特定类型的指令重排序**(编译器和处理器优化可能导致乱序执行)。
- **强制刷新 CPU 缓存**,确保多线程间的 **内存可见性**。
JVM 依赖底层 CPU 的内存屏障指令(如 x86 的 `mfence`/`lfence`/`sfence`),抽象为以下四种:
- **LoadLoad**:确保 `Load1` 的读取操作在 `Load2` 及后续读取之前完成。 示例:`volatile` 读后的普通读。
- **StoreStore**:确保 `Store1` 的写入操作在 `Store2` 及后续写入之前对其他线程可见。示例:`volatile` 写前的普通写。
- **LoadStore**:确保 `Load1` 的读取操作在 `Store2` 及后续写入之前完成。
- **StoreLoad**:确保 `Store1` 的写入对所有线程可见后,才执行 `Load2` 的读取。 **开销最大**(如 `volatile` 写后的 `volatile` 读会插入此屏障)。
**内存屏障的应用场景**
- **`volatile` 变量**
- **写操作**:插入 `StoreStore` + `StoreLoad` 屏障。
- **读操作**:插入 `LoadLoad` + `LoadStore` 屏障。
- **`synchronized` 锁**
- 进入临界区(加锁)和退出(解锁)时插入屏障,保证可见性和有序性。
- **`final` 字段**
- 构造函数中的 `final` 字段写入后插入屏障,确保正确初始化对其他线程可见。
**内存屏障的作用**
- **禁止重排序**:防止编译器和 CPU 优化破坏多线程逻辑(如单例模式的 DCL 问题)。
- **保证可见性**:强制将工作内存的修改刷回主内存,并失效其他线程的缓存。
- **保证有序性**:确保临界区代码按预期顺序执行(如 `happens-before` 规则的实现基础)。
**底层实现**
- **x86 CPU**:`StoreLoad` 对应 `mfence` 指令,其他屏障通常无实际指令(因 x86 强内存模型已满足大部分需求)。
- **ARM/PowerPC**:弱内存模型需显式插入更多屏障指令。
- **JVM 的封装**:通过 `Unsafe` 类提供 `loadFence()`/`storeFence()`/`fullFence()` 方法(如 `VarHandle` 内部使用)。
**示例:`volatile` 的屏障插入**
```java
volatile int flag = 0;
int value = 0;
void write() {
value = 42; // 普通写
// StoreStore 屏障(确保 value=42 先刷入主内存)
flag = 1; // volatile 写
// StoreLoad 屏障(保证写操作对所有线程可见)
}
void read() {
if (flag == 1) { // volatile 读
// LoadLoad + LoadStore 屏障
System.out.println(value); // 保证读到 value=42
}
}
```
### 【中等】`volatile` 有什么作用?⭐⭐⭐⭐⭐
`volatile` 是轻量级的线程同步工具。**`volatile` 可以保证可见性和有序性,但不保证原子性**。适用于状态标志、DCL 单例等场景。
**注意事项**
- **不要滥用**:仅适用于简单状态同步,复杂操作仍需锁或原子类。
- **不适用于复合操作**:如 `check-then-act`(需 `synchronized` 或 CAS)。

::: info 保证可见性
:::
- **强制线程每次读取 `volatile` 变量时**,直接从主内存获取最新值(跳过工作内存缓存)。
- **强制线程每次写入 `volatile` 变量时**,立即同步到主内存,使其他线程立即可见。
::: info 禁止指令重排序
:::
- 通过插入 **内存屏障(Memory Barrier)** 禁止编译器和 CPU 对 `volatile` 变量的读写操作进行重排序。
- **双重检查锁(DCL)单例模式** 中必须用 `volatile` 修饰实例变量,防止对象未初始化完成就被使用。
::: info 不保证原子性
:::
`volatile` **不能替代 `synchronized`**,例如 `volatile int i++;` 仍存在竞态条件(需用 `AtomicInteger`)。
适用场景:**单线程写、多线程读** 的变量(如开关标志)。
::: info volatile 底层实现原理
:::
- **写操作**:插入 `StoreStore` + `StoreLoad` 屏障,确保写入前所有操作完成,且结果全局可见。
- **读操作**:插入 `LoadLoad` + `LoadStore` 屏障,确保读取后所有操作依赖最新值。
四类屏障的插入规则(JSR-133 规范):
| 屏障 | 插入位置 | 作用 |
| :----------- | :--------------------- | :----------------------------------- |
| `StoreStore` | 每个 `volatile` 写之前 | 禁止上面的普通写与 volatile 写重排序 |
| `StoreLoad` | 每个 `volatile` 写之后 | 禁止 volatile 写与其后的读/写重排序 |
| `LoadLoad` | 每个 `volatile` 读之后 | 禁止下面的普通读与 volatile 读重排序 |
| `LoadStore` | 每个 `volatile` 读之后 | 禁止下面的普通写与 volatile 读重排序 |
**x86 硬件基础**:`volatile` 写最终编译为一条带 `lock` 前缀的指令(如 `lock addl $0, 0(%rsp)`)。`lock` 前缀触发缓存一致性协议(MESI),将当前核心缓存行写回主内存并使其他核心的对应缓存行失效——这是可见性的硬件基础;同时 `lock` 指令本身充当全量内存屏障,等效 `StoreLoad`。
这正是 DCL 单例必须加 `volatile` 的底层原因:没有 `volatile`,`instance = new Singleton()` 的「分配内存 → 初始化 → 引用赋值」三步中后两步可能重排序,其他线程会读到未初始化完成的对象(详见下文 DCL 题)。
::: info volatile 应用场景
:::
**状态标志位**
```java
volatile boolean running = true;
void stop() { running = false; } // 线程 A
void run() { while (running) { ... } } // 线程 B
```
**双重检查锁(DCL)**
```java
class Singleton {
private static volatile Singleton instance;
static Singleton getInstance() {
if (instance == null) {
synchronized (Singleton.class) {
if (instance == null) {
instance = new Singleton(); // 禁止重排序
}
}
}
return instance;
}
}
```
**发布不可变对象**
```java
volatile Map config = readConfig(); // 保证引用可见性
```
::: info 硬件视角:MESI 协议与 Store Buffer —— 为什么 volatile 写不"即时"?
:::
**(1)MESI 协议的四个状态**
现代 x86 CPU 通过 MESI 协议保证多核之间的缓存一致性:
| 状态 | 全称 | 含义 |
| :---------------- | :----- | :----------------------------------------- |
| **M** (Modified) | 已修改 | 缓存行仅在本核心,已被修改,与主内存不一致 |
| **E** (Exclusive) | 独占 | 缓存行仅在本核心,与主内存一致 |
| **S** (Shared) | 共享 | 缓存行在多个核心中,与主内存一致 |
| **I** (Invalid) | 失效 | 缓存行无效,读取时需从主内存或其他核心获取 |
**(2)Store Buffer —— volatile 写延迟的根源**
CPU 核在写入共享缓存行前,必须先通过 MESI 协议将其他核心的对应缓存行置为 **I** 状态。这个协商过程需要跨核心通信(几十到上百个 CPU 周期)。为了提高执行效率,CPU 引入了 **Store Buffer**:写操作先进入 Store Buffer,CPU 不等 MESI 协商完成就继续执行后续指令。
**这正是 `volatile` 需要内存屏障的硬件原因**:`volatile` 写后的 `StoreLoad` 屏障会**强制刷新 Store Buffer**(等待所有 pending 写入全局可见),保证其他核心后续读取一定能看到最新值。没有这个屏障,写操作可能只在 Store Buffer 中,其他核心读取时从自己的缓存读到旧值。
**(3)Invalidate Queue —— volatile 读延迟的根源**
当一个核心收到其他核心发来的 Invalidate 消息时,如果立即处理需要等待当前缓存操作完成,CPU 会先将 Invalidate 消息放入 **Invalidate Queue** 异步处理。这导致:即使写入方已刷新 Store Buffer,读取方可能因 Invalidate Queue 中堆积的消息而未真正使对应缓存行失效,仍读到旧值。
**`volatile` 读后的 `LoadLoad` + `LoadStore` 屏障会强制排空 Invalidate Queue**,确保读取前所有已收到的失效消息都被处理完毕,读到真正的最新值。
**一句话总结**:`volatile` 的可见性不是"魔法瞬间同步",而是通过 CPU 内存屏障强制 Store Buffer 刷新 + Invalidate Queue 排空,代价是流水线停顿(Pipeline Stall),单次 volatile 读约 20-100 个 CPU 周期(对比普通读的 L1 cache hit 约 4 个周期)。
**(4)跨语言对比:Java volatile vs C++ atomic vs Go atomic**
| 特性 | Java `volatile` | C++ `std::atomic` (默认 seq_cst) | Go `sync/atomic` |
| :------------------ | :--------------------------------- | :--------------------------------- | :---------------------- |
| **默认内存序** | 相当于 `acq_rel` (acquire-release) | `seq_cst` (顺序一致性,更强但更慢) | `seq_cst` |
| **原子性** | 仅单次读/写(不保证 RMW) | 保证 RMW(`fetch_add` 等) | 保证 RMW |
| **StoreLoad 屏障** | ✅ 有(x86 `lock` 前缀) | ✅ 有(更强,含全局顺序) | ✅ 有 |
| **性能代价(x86)** | ~20-100 cycles(仅屏障) | ~30-150 cycles(含全局排序) | ~10-50 cycles(更轻量) |
- **Java volatile**:语义上等价于 C++ `memory_order_acquire`(读)+ `memory_order_release`(写),是三者中设计最简洁的。
- **C++ atomic**:提供 6 种内存序(`relaxed/consume/acquire/release/acq_rel/seq_cst`),给予极致控制但也引入了极高的心智负担——选错内存序可能导致"逻辑正确但 CPU 仍重排"的 bug。
- **Go atomic**:与 Java 设计哲学相反——Go 推荐显式使用 `atomic` 包操作基本类型,而不是依赖"语言关键字保证可见性"。Go 的 `sync.Mutex` 才提供类似 Java `synchronized` 的 happen-before 保证。
**(5)volatile vs synchronized**
| **维度** | **volatile** | **synchronized** |
| ------------ | ------------------- | ------------------- |
| **原子性** | ❌ 不保证 | ✔️ 保证 |
| **可见性** | ✔️ 保证 | ✔️ 保证 |
| **有序性** | ✔️ 保证(禁止重排) | ✔️ 保证(加锁串行) |
| **性能** | 高(无锁) | 低(涉及加锁/解锁) |
| **适用场景** | 状态标志、DCL | 复合操作、临界区 |
### 【中等】volatile 能完全保证并发安全吗?⭐⭐⭐⭐
线程安全需要具备:可见性、原子性、顺序性。**`volatile` 不保证原子性,所以决定了它不能彻底地保证线程安全**。
我们通过下面的代码即可证明:
```java
public class VolatileAtomicityDemo {
public volatile static int inc = 0;
public void increase() {
inc++;
}
public static void main(String[] args) throws InterruptedException {
ExecutorService threadPool = Executors.newFixedThreadPool(5);
VolatileAtomicityDemo volatileAtomicityDemo = new VolatileAtomicityDemo();
for (int i = 0; i < 5; i++) {
threadPool.execute(() -> {
for (int j = 0; j < 500; j++) {
volatileAtomicityDemo.increase();
}
});
}
// 等待 1.5 秒,保证上面程序执行完成
Thread.sleep(1500);
System.out.println(inc);
threadPool.shutdown();
}
}
```
正常情况下,运行上面的代码理应输出 `2500`。但你真正运行了上面的代码之后,你会发现每次输出结果都小于 `2500`。
为什么会出现这种情况呢?不是说好了,`volatile` 可以保证变量的可见性嘛!
也就是说,如果 `volatile` 能保证 `inc++` 操作的原子性的话。每个线程中对 `inc` 变量自增完之后,其他线程可以立即看到修改后的值。5 个线程分别进行了 500 次操作,那么最终 inc 的值应该是 5\*500=2500。
很多人会误认为自增操作 `inc++` 是原子性的,实际上,`inc++` 其实是一个复合操作,包括三步:
1. 读取 inc 的值。
2. 对 inc 加 1。
3. 将 inc 的值写回内存。
`volatile` 是无法保证这三个操作是具有原子性的,有可能导致下面这种情况出现:
1. 线程 1 对 `inc` 进行读取操作之后,还未对其进行修改。线程 2 又读取了 `inc` 的值并对其进行修改(+1),再将 `inc` 的值写回内存。
2. 线程 2 操作完毕后,线程 1 对 `inc` 的值进行修改(+1),再将 `inc` 的值写回内存。
这也就导致两个线程分别对 `inc` 进行了一次自增操作后,`inc` 实际上只增加了 1。
其实,如果想要保证上面的代码运行正确也非常简单,利用 `synchronized`、`Lock` 或者 `AtomicInteger` 都可以。
使用 `synchronized` 改进:
```java
public synchronized void increase() {
inc++;
}
```
使用 `AtomicInteger` 改进:
```java
public AtomicInteger inc = new AtomicInteger();
public void increase() {
inc.getAndIncrement();
}
```
使用 `ReentrantLock` 改进:
```java
Lock lock = new ReentrantLock();
public void increase() {
lock.lock();
try {
inc++;
} finally {
lock.unlock();
}
}
```
### 【中等】`volatile` 和 `synchronized` 有什么区别?`volatile` 能替代 `synchronized` 吗?⭐⭐⭐⭐⭐
**`volatile` 无法替代 `synchronized` ,因为 `volatile` 无法保证操作的原子性**。
**volatile 和 synchronized 的特性区别**:
| 特性 | `volatile` | `synchronized` |
| ---------- | --------------------- | --------------------- |
| **原子性** | ❌ 不保证(如 `i++`) | ✔️ 保证 |
| **可见性** | ✔️ 强制主内存读写 | ✔️ 通过锁机制保证 |
| **有序性** | ✔️ 禁止重排序 | ✔️ 串行化执行 |
| **性能** | ⚡ 轻量级(无锁) | 🔒 较重(上下文切换) |
**volatile 和 synchronized 的实现区别**:
- **volatile**:
- 通过 **内存屏障** 禁止指令重排序
- 强制 **CPU 缓存失效** 保证可见性
- 底层使用 **LoadLoad/StoreStore 等屏障指令**
- **synchronized**:
- 通过 **Monitor 监视器锁**(对象头 Mark Word)
- 包含 **偏向锁→轻量级锁→重量级锁** 的升级过程
- 保证 **代码块/方法** 的排他性访问
### 【中等】`synchronized` 有什么作用?⭐⭐⭐⭐⭐
`synchronized` 是 Java 最基础的线程同步机制,通过 **原子性、可见性、有序性** 保障线程安全,适用于需要 **强一致性** 的场景,但需合理控制锁粒度以避免性能问题。
`synchronized` 有 3 种应用方式:
- **同步实例方法** - 对于普通同步方法,锁是当前实例对象
- **同步静态方法** - 对于静态同步方法,锁是当前类的 `Class` 对象
- **同步代码块** - 对于同步方法块,锁是 `synchonized` 括号里配置的对象

### 【中等】`synchronized` 的实现原理是什么?⭐⭐⭐⭐⭐
`synchronized` 的底层实现涉及 **Java 对象头、Monitor(监视器)、锁升级机制** 等。
**`synchronized` 修饰代码块时,在代码块前后植入 monitorenter 和 monitorexit 字节码指令,相当于加锁和解锁**。
**`synchronized` 修饰方法时,会在方法的访问标志上设置一个 `ACC_SYNCHRONIZED` 标记**。线程每次访问方法,会进行检查,若设置了 `ACC_SYNCHRONIZED` 标记,执行线程将先持有 `Monitor` 对象,然后再执行方法。在该方法运行期间,其它线程将无法获取到该 Mointor 对象,当方法执行完成后,再释放该 Monitor 对象。
**(1)对象头与 Mark Word**
每个 Java 对象在内存中由 **对象头(Header)、实例数据(Instance Data)、对齐填充(Padding)** 组成。对象头主要有两部分:Mark Word 和 Klass Pointer。
`synchronized` 的锁信息存储在 **对象头** 的 **Mark Word** 中,主要包括:
- **锁状态**(无锁、偏向锁、轻量级锁、重量级锁)
- **持有锁的线程 ID**
- **GC 分代年龄**
- **哈希码(HashCode)**
Mark Word 记录了对象和锁有关的信息。Mark Word 在 64 位 JVM 中的长度是 64bit,我们可以一起看下 64 位 JVM 的存储结构是怎么样的。如下图所示:

**(2)Monitor(监视器)**
每个 Java 对象都关联一个 **Monitor(监视器)**,用于实现同步机制。
HotSpot 中 Monitor 由 C++ 的 `ObjectMonitor` 类实现(`src/hotspot/share/runtime/objectMonitor.hpp`),核心字段:
| 字段 | 作用 |
| :------------ | :------------------------------------------------------------- |
| `_owner` | 指向当前持有锁的线程 |
| `_recursions` | 锁重入次数(`synchronized` 可重入的实现基础) |
| `_EntryList` | 竞争锁失败、处于 BLOCKED 状态的线程队列 |
| `_WaitSet` | 调用 `wait()` 后进入 WAITING 状态的线程队列 |
| `_cxq` | 多线程竞争时先进入的单向链表(与 `_EntryList` 配合做唤醒策略) |
**`monitorenter` 的执行流程**:线程先尝试 CAS 把 `_owner` 置为当前线程;失败则进入 `_cxq`/`_EntryList` 自旋或阻塞;`monitorexit` 将 `_recursions` 减 1,减到 0 时 `_owner` 置空并唤醒等待线程。`javac` 会为同步块生成**两条 `monitorexit`**(正常退出 + 异常表兜底),保证锁必定释放。
**重量级锁的成本**:竞争失败的线程最终通过 `ObjectMonitor::EnterI` 挂起(`park`),底层依赖操作系统互斥原语(Linux 上是 `futex`),一次线程上下文切换约 1μs~5μs,这就是「重量级」的真正含义。
### 【困难】JDK 6 对 `synchronized` 进行了哪些优化?⭐⭐⭐⭐
**JDK 6 以后,`synchronized` 做了大量的优化,其性能已经与 `Lock` 、`ReadWriteLock` 基本上持平**。
::: info 锁升级
:::
JDK 1.6 后,`synchronized` 采用 **锁升级** 机制优化性能,避免直接使用重量级锁带来的性能损耗。锁的状态变化如下:
```mermaid
graph LR
A[无锁] -->|第一个线程访问| B[偏向锁]
B -->|其他线程竞争| C[轻量级锁]
C -->|CAS 自旋失败/竞争激烈| D[重量级锁]
B -.->|撤销偏向| C
D -.->|不可降级| D
```
| 锁状态 | 适用场景 | 实现方式 |
| :----------- | :----------- | :-------------------- |
| **无锁** | 初始状态 | Mark Word 无锁标记 |
| **偏向锁** | 单线程访问 | Mark Word 记录线程 ID |
| **轻量级锁** | 少量线程竞争 | CAS 自旋 |
| **重量级锁** | 高并发竞争 | 操作系统 Mutex 锁 |
**偏向锁**
- **适用场景**:只有一个线程访问同步块。
- **实现方式**:
- 在 Mark Word 中记录 **线程 ID**,后续该线程进入时无需 CAS 操作。
- 如果其他线程尝试获取锁,偏向锁会 **撤销**(Revoke)并升级为轻量级锁。
**轻量级锁**
- **适用场景**:少量线程竞争,且线程交替执行。
- **实现方式**:
- 线程通过 **CAS(Compare-And-Swap)** 尝试获取锁。
- 如果成功,则线程获取了锁;
- 如果失败,表示有其他线程持有锁,此时升级为 **重量级锁**。
- **解锁方式**:线程退出同步块时,JVM 会将对象头中的 Mark Word 恢复为原始值。
**重量级锁**
- **适用场景**:高并发竞争。
- **实现方式**:
- 依赖 **操作系统 Mutex 锁**(互斥量)。
- 未获取锁的线程会被 **阻塞(Blocked)**,进入等待队列等待唤醒。
- **解锁方式**:线程释放重量级锁时,JVM 会唤醒所有阻塞的线程,允许它们再次尝试获取锁。
Mark Word 记录了对象和锁有关的信息。Mark Word 在 64 位 JVM 中的长度是 64bit,我们可以一起看下 64 位 JVM 的存储结构是怎么样的。如下图所示:

锁升级功能主要依赖于 Mark Word 中的锁标志位和释放偏向锁标志位,`synchronized` 同步锁就是从偏向锁开始的,随着竞争越来越激烈,偏向锁升级到轻量级锁,最终升级到重量级锁。
::: info 锁消除
:::
锁消除是指在即时编译(JIT)时,JVM 会对代码进行逃逸分析。如果发现一段代码中使用的锁对象不会逃逸到方法外部,也就是其他线程无法访问到该锁对象,那么 JVM 会认为该锁是无意义的,从而将锁的代码消除,避免不必要的锁竞争,提高程序的性能。
**锁消除实现原理**:
(1)**逃逸分析**:JVM 会分析对象的作用域。如果一个对象在方法内部创建,并且不会被外部方法引用,那么这个对象就不会逃逸出该方法。
(2)**锁消除**:由于 `StringBuffer` 的 `append` 方法是 `synchronized` 方法,但 `sb` 对象不会逃逸,JVM 经过逃逸分析后,会将 `append` 方法中的锁代码消除,从而避免了锁的开销。
【示例】锁消除
```java
public class LockEliminationExample {
public static String concatString(String s1, String s2, String s3) {
// 创建一个 StringBuffer 对象,它不会逃逸出该方法
StringBuffer sb = new StringBuffer();
sb.append(s1);
sb.append(s2);
sb.append(s3);
return sb.toString();
}
public static void main(String[] args) {
String result = concatString("Hello", " ", "World");
System.out.println(result);
}
}
```
在这个示例中,`StringBuffer` 对象 `sb` 只在 `concatString` 方法内部使用,不会被其他方法访问。因此,JVM 在即时编译时会进行逃逸分析,并将 `append` 方法中的锁代码消除。
::: info 锁粗化
:::
锁粗化是指:在 JIT 编译器动态编译时,如果发现几个相邻的同步块使用的是同一个锁实例,那么 JIT 编译器将会把这几个同步块合并为一个大的同步块,从而避免一个线程“反复申请、释放同一个锁“所带来的性能开销。
如果**一系列的连续操作都对同一个对象反复加锁和解锁**,频繁的加锁操作就会导致性能损耗。
### 【困难】synchronized 锁升级的详细过程是怎样的?⭐⭐⭐⭐⭐
锁升级是 JDK 6 对 `synchronized` 的核心优化,理解其细节是资深工程师的必备知识。
**(1)无锁 → 偏向锁**
- 线程首次进入同步块,CAS 将线程 ID 写入 Mark Word,标志位改为 `01`(可偏向)。
- 后续同一线程进入只需比对线程 ID,无需 CAS,性能接近无锁。
- **延迟偏向**:JVM 启动后 4 秒才启用偏向锁(`-XX:BiasedLockingStartupDelay=4000`),避免启动阶段的不必要开销。
**(2)偏向锁 → 轻量级锁**
- 出现第二个线程竞争时,偏向锁撤销(Revoke):
- 等待全局安全点(safepoint),暂停持有偏向锁的线程。
- 检查持有线程是否在同步块内:是则升级为轻量级锁;否则重置为无锁。
- **批量重偏向**:同一类的对象撤销偏向达到 20 次阈值后,该类的新对象直接偏向新线程。
- **批量撤销**:撤销达到 40 次后,该类禁用偏向锁。
**(3)轻量级锁 → 重量级锁**
- 线程在同步块外创建 Lock Record,CAS 将 Mark Word 复制到 Lock Record,并尝试将对象头指向 Lock Record。
- 成功则获取锁,失败则自旋重试。
- 自旋超过阈值(自适应自旋,JDK 6+ 根据历史成功率动态调整)仍失败,升级为重量级锁。
- 重量级锁的 `ObjectMonitor` 底层依赖操作系统互斥原语:竞争失败的线程先进入 `_EntryList`,最终通过 `park`/`unpark` 挂起与唤醒(Linux 上对应 `futex` 系统调用),一次线程上下文切换约 1μs~5μs,这就是「重量级」的成本来源。
**(4)锁降级**
- **锁不可降级**:一旦升级为重量级锁,无法回退。这是为了简化实现,避免状态频繁切换的开销。
- **GC 时特殊处理**:GC 时若发现锁已无竞争,可能降级(仅 GC 安全点),但这是 JVM 内部优化,不应依赖。
**(5)版本演进:JDK 15 起废弃偏向锁(JEP 374)**
- **JDK 15(JEP 374)**:偏向锁被标记为废弃并**默认禁用**(`-XX:-UseBiasedLocking`)。原因:偏向锁的撤销需要等待全局安全点(STW),在动辄数百线程的现代应用中,撤销成本已高于收益,HotSpot 团队决定退役该特性以简化同步子系统。
- **JDK 18**:偏向锁相关实现代码彻底移除。
- **对升级路径的影响**:JDK 15 之后默认路径变为 **无锁 → 轻量级锁 → 重量级锁**,不再经过偏向锁。面试中若仍把偏向锁当作默认第一步,会被认为知识停留在旧版本。
- **JDK 24(JEP 491)**:`synchronized` 配合虚拟线程使用时不再 Pinning 载体线程,扫清了存量 `synchronized` 代码迁移虚拟线程的最大障碍。
**Mark Word 状态对照表(64 位 JVM)**:
| 锁状态 | 25bit | 31bit | 1bit | 4bit | 1bit(偏向标志) | 2bit(锁标志) |
| ------------ | --------------------------- | -------- | ------ | -------- | -------------- | ------------ |
| **无锁** | unused | hashCode | unused | 分代年龄 | 0 | 01 |
| **偏向锁** | ThreadID(54) + Epoch(2) | | | 分代年龄 | 1 | 01 |
| **轻量级锁** | 指向栈中 Lock Record 的指针 | | | | | 00 |
| **重量级锁** | 指向 Monitor 的指针 | | | | | 10 |
| **GC 标记** | 空 | | | | | 11 |
### 【困难】为什么 DCL 单例模式需要 volatile?⭐⭐⭐⭐
**双重检查锁(Double-Checked Locking, DCL)** 单例模式中,`volatile` 修饰实例变量是**必须的**,否则在多线程环境下可能出现"获取到未初始化完成的对象"问题。
**问题根源:对象的创建不是原子操作**
`instance = new Singleton();` 在 JVM 中分三步:
```java
memory = allocate(); // 1. 分配对象内存空间
instance(memory); // 2. 初始化对象(调用构造方法)
instance = memory; // 3. 将引用指向内存地址
```
**指令重排序**可能导致步骤 2 和 3 对调:
```java
memory = allocate(); // 1. 分配内存
instance = memory; // 2. 引用指向内存(此时对象未初始化!)
instance(memory); // 3. 初始化对象
```
**问题场景**:
1. 线程 A 执行到步骤 2(已赋值但未初始化),此时 instance != null。
2. 线程 B 第一次检查 `instance == null` 为 false,直接返回 instance。
3. 线程 B 使用了**未初始化完成**的对象,导致 NPE 或数据错误。
**volatile 的作用**:通过 StoreStore 屏障禁止 2、3 步重排序,保证对象初始化完成后才对其他线程可见。
```java
class Singleton {
private static volatile Singleton instance; // volatile 必须加!
static Singleton getInstance() {
if (instance == null) { // 第一次检查,避免不必要的锁
synchronized (Singleton.class) {
if (instance == null) { // 第二次检查,避免重复创建
instance = new Singleton(); // volatile 禁止重排序
}
}
}
return instance;
}
}
```
**更好的替代方案**:静态内部类(利用类加载机制保证线程安全,无需 volatile)
```java
class Singleton {
private Singleton() {}
private static class Holder {
static final Singleton INSTANCE = new Singleton();
}
public static Singleton getInstance() {
return Holder.INSTANCE; // 类加载时初始化,JVM 保证线程安全
}
}
```
### 【中等】final 关键字可以保证线程的可见性吗?⭐⭐
**final 本身不能直接保证线程间的可见性**。
**但 final 修饰的字段在正确初始化后,对其他线程是可见的(JMM 保证)**。对象构造完成时,`final` 字段的初始化值对所有线程立即可见。不需要额外的同步措施(如 `volatile` / `synchronized`)。
final 的线程可见性仅限于**初始化阶段**,适用于:
- 声明不可变常量(如 `final int MAX = 100`)
- 构造线程安全对象(如 `final AtomicReference`)
如果需要**持续可见性**(如状态标志位),仍需使用 `volatile` 或同步机制。
非 final 字段对比:
```java
class Example {
final int x = 42; // 构造后所有线程看到 x=42
int y = 10; // 其他线程可能看到 y=0(默认值)或 10
}
```
**底层实现机制**
- **JVM 会插入内存屏障**:确保 final 字段初始化后对所有线程可见。
- **与 happens-before 规则关联**:对象构造结束 happens-before 于其他线程看到该对象。
**使用限制**
| 场景 | 是否线程安全 | 说明 |
| ------------------ | ------------ | ---------------------------------- |
| **final 基本类型** | ✔️ 安全 | int/long 等初始化后不可变 |
| **final 引用类型** | ⚠️ 部分安全 | 引用不可变,但对象内部状态可能变化 |
| **非 final 字段** | ❌ 不安全 | 需要额外同步 |
危险示例:
```java
final Map map = new HashMap<>();
// map 引用不可变,但 map.put() 操作非线程安全!
```
**最佳实践**
(1)**优先用 final 修饰不可变数据**
```java
public class SafeCounter {
private final AtomicLong count = new AtomicLong(0); // 线程安全
}
```
(2)**需要跨线程可见的变量应使用 volatile**
```java
private volatile boolean running = true;
```
(3)**避免以下错误用法**:
```java
// 错误!final 不能保证对象内部线程安全
final List unsafeList = new ArrayList<>();
```
## Java 线程
### 【中等】Java 线程生命周期有哪些状态?状态之间如何切换?⭐⭐⭐⭐⭐
`java.lang.Thread.State` 中定义了 **6** 种不同的线程状态,在给定的一个时刻,线程只能处于其中的一个状态。

以下是各状态的说明,以及状态间的联系:
- **开始(NEW)** - 尚未调用 `start` 方法的线程处于此状态。此状态意味着:**创建的线程尚未启动**。
- **可运行(RUNNABLE)** - 已经调用了 `start` 方法的线程处于此状态。此状态意味着,**线程已经准备好了**,一旦被线程调度器分配了 CPU 时间片,就可以运行线程。
- 在操作系统层面,线程有 READY 和 RUNNING 状态;而在 JVM 层面,只能看到 RUNNABLE 状态,所以 Java 系统一般将这两个状态统称为 RUNNABLE(运行中) 状态 。
- **阻塞(BLOCKED)** - 此状态意味着:**线程处于被阻塞状态**。表示线程在等待 `synchronized` 的隐式锁(Monitor lock)。`synchronized` 修饰的方法、代码块同一时刻只允许一个线程执行,其他线程只能等待,即处于阻塞状态。当占用 `synchronized` 隐式锁的线程释放锁,并且等待的线程获得 `synchronized` 隐式锁时,就又会从 `BLOCKED` 转换到 `RUNNABLE` 状态。
- **等待(WAITING)** - 此状态意味着:**线程无限期等待,直到被其他线程显式地唤醒**。 阻塞和等待的区别在于,阻塞是被动的,它是在等待获取 `synchronized` 的隐式锁。而等待是主动的,通过调用 `Object.wait` 等方法进入。
- 进入:`Object.wait()`;退出:`Object.notify` / `Object.notifyAll`
- 进入:`Thread.join()`;退出:被调用的线程执行完毕
- 进入:`LockSupport.park()`;退出:`LockSupport.unpark`
- **定时等待(TIMED_WAITING)** - 等待指定时间的状态。一个线程处于定时等待状态,是由于执行了以下方法中的任意方法:
- 进入:`Thread.sleep(long)`;退出:时间结束
- 进入:`Object.wait(long)`;退出:时间结束 / `Object.notify` / `Object.notifyAll`
- 进入:`Thread.join(long)`;退出:时间结束 / 被调用的线程执行完毕
- 进入:`LockSupport.parkNanos(long)`;退出:`LockSupport.unpark`
- 进入:`LockSupport.parkUntil(long)`;退出:`LockSupport.unpark`
- **终止 (TERMINATED)** - 线程 `run()` 方法执行结束,或者因异常退出了 `run()` 方法,则该线程结束生命周期。死亡的线程不可再次复生。
**状态切换速查表(面试高频追问)**:
| 状态切换 | 触发方法/事件 | 是否释放锁 |
| :----------------------- | :-------------------------------------------------------------------------- | :--------------------- |
| NEW → RUNNABLE | `Thread.start()` | — |
| RUNNABLE → BLOCKED | 竞争 `synchronized` 锁失败(进入 ObjectMonitor 的 `_EntryList`) | 不涉及 |
| BLOCKED → RUNNABLE | 获取到 `synchronized` 锁 | 获得锁 |
| RUNNABLE → WAITING | `Object.wait()` / `Thread.join()` / `LockSupport.park()` | `wait()` 释放锁 |
| WAITING → RUNNABLE | `notify()`/`notifyAll()`(需重新竞争锁)/ 被 join 线程结束 / `unpark()` | 重新获取锁后进入 |
| RUNNABLE → TIMED_WAITING | `sleep(long)` / `wait(long)` / `join(long)` / `parkNanos()` / `parkUntil()` | 仅 `wait(long)` 释放锁 |
| TIMED_WAITING → RUNNABLE | 超时到期或被唤醒 | 同 WAITING |
| RUNNABLE → TERMINATED | `run()` 正常结束或抛出未捕获异常 | 释放持有的所有锁 |
**高频追问点**:
- `sleep()` **不释放锁**,进入 TIMED_WAITING;`wait()` **释放锁**,进入 WAITING(带超时则 TIMED_WAITING)。
- `notify()` 唤醒的线程不会立即执行,而是进入 `_EntryList` 重新竞争锁(BLOCKED → RUNNABLE)。
- JVM 把 OS 层面的 READY 和 RUNNING 合并为 RUNNABLE,Java 层面无法区分「在等 CPU」和「正在 CPU 上跑」。
> 👉 扩展阅读:
>
> - [Java Thread Methods and Thread States](https://www.w3resource.com/java-tutorial/java-threadclass-methods-and-threadstates.php)
> - [Java 线程的 5 种状态及切换(透彻讲解)](https://blog.csdn.net/pange1991/article/details/53860651)
> - [Java 线程运行怎么有第六种状态? - Dawell 的回答](https://www.zhihu.com/question/56494969/answer/154053599)
### 【中等】Java 中,创建线程有几种方式?⭐⭐⭐⭐
一般来说,创建线程有很多种方式,例如:
- 实现 `Runnable` 接口(推荐)
- 继承 `Thread` 类(不推荐,因为不灵活,Java 不支持多继承)
- 实现 `Callable` 接口 + `FutureTask`,支持返回值
- 通过线程池(生产环境推荐)
- 使用 `CompletableFuture`
- ...

虽然,看似有多种多样的创建线程方式。但是,**从本质上来说,Java 就只有一种方式可以创建线程,那就是通过 `new Thread().start() ` 创建。不管是哪种方式,最终还是依赖于 `new Thread().start()`**。
> 👉 扩展阅读:[大家都说 Java 有三种创建线程的方式!并发编程中的惊天骗局!](https://mp.weixin.qq.com/s/NspUsyhEmKnJ-4OprRFp9g)。
### 【简单】可以直接调用 `Thread.run()` 方法么?⭐⭐⭐
可以直接调用 `Thread.run()` 方法,但是它的行为和普通方法一样,不会启动新线程去执行。**调用 `start()` 方法方可启动线程并使线程进入就绪状态,直接执行 `run()` 方法的话不会以多线程的方式执行。**
- **`run()` 方法是线程的执行体**。
- **`start()` 方法负责启动线程,然后 JVM 会让这个线程去执行 `run()` 方法**。
### 【中等】`Thread.start()` 的内部原理是什么?⭐⭐
`Thread.start()` 的核心工作:
1. **检查线程状态**:若线程非 `NEW` 状态,抛出 `IllegalThreadStateException`(即不能重复 start)。
2. **加入线程组**:将线程加入其所属的 `ThreadGroup`。
3. **调用 native `start0()`**:通过 JNI 调用底层 OS API 创建内核线程。
4. **OS 线程启动后回调 `run()`**:JVM 会在新线程中调用 `Thread.run()`(若指定了 `Runnable` 则委托执行)。
**关键点**:`start()` 是由 JVM 实现的,它做了两件事——创建 OS 线程 + 让 OS 线程执行 `run()`。这就是为什么 `start()` 只能调用一次:第二次调用时线程已经不是 `NEW` 状态。
### 【中等】如何正确停止 Java 线程?⭐⭐⭐
**对于 Java 而言,最正确的停止线程的方式是:通过 `Thread.interrupt` 和 `Thread.isInterrupted` 配合来控制线程终止**。
- `Thread.interrupt()`:设置线程的中断标志位(不会直接停止线程)。
- `Thread.isInterrupted()`:检查中断状态。
【示例】正确停止线程的方式——`Thread.interrupt`
```java
public class ThreadStopDemo {
public static void main(String[] args) throws Exception {
Thread thread = new Thread(new MyTask(), "MyTask");
thread.start();
TimeUnit.MILLISECONDS.sleep(10);
thread.interrupt();
}
private static class MyTask implements Runnable {
private long count = 0L;
@Override
public void run() {
System.out.println(Thread.currentThread().getName() + " 线程启动");
// 通过 Thread.interrupted 和 interrupt 配合来控制线程终止
while (!Thread.currentThread().isInterrupted() && count < 10000) {
System.out.println("count = " + count++);
}
System.out.println(Thread.currentThread().getName() + " 线程终止");
}
}
}
// 输出(count 未到 10000,线程就主动结束):
// MyTask 线程启动
// count = 0
// count = 1
// ...
// count = 840
// count = 841
// count = 842
// MyTask 线程终止
```
### 【中等】可以使用 `Thread.stop`,`Thread.suspend` 和 `Thread.resume` 停止线程吗?为什么?⭐⭐
`Thread.stop`,`Thread.suspend` 和 `Thread.resume` 方法已经被 Java 标记为 `@Deprecated`。为什么废弃呢?
- **`Thread.stop` 会直接把线程停止,这样就没有给线程足够的时间来处理想要在停止前保存数据的逻辑,任务戛然而止,会导致出现数据完整性等问题**。
- 而对于`Thread.suspend` 和 `Thread.resume` 而言,它们的问题在于:**如果线程调用 `Thread.suspend`,它并不会释放锁,就开始进入休眠,但此时有可能仍持有锁,这样就容易导致死锁问题**。因为这把锁在线程被 `Thread.resume` 之前,是不会被释放的。假设线程 A 调用了 `Thread.suspend` 方法让线程 B 挂起,线程 B 进入休眠,而线程 B 又刚好持有一把锁,此时假设线程 A 想访问线程 B 持有的锁,但由于线程 B 并没有释放锁就进入休眠了,所以对于线程 A 而言,此时拿不到锁,也会陷入阻塞,那么线程 A 和线程 B 就都无法继续向下执行。
【示例】`Thread.stop` 终止线程,导致线程任务戛然而止
```java
public class ThreadStopErrorDemo {
public static void main(String[] args) {
MyTask thread = new MyTask();
thread.start();
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
// 终止线程
thread.stop();
// 确保线程终止后,才执行下面的代码
while (thread.isAlive()) { }
// 输出两个计数器的最终状态
thread.print();
}
/**
* 持有两个计数器,run 方法中每次执行都会使计数器自增
*/
private static class MyTask extends Thread {
private int i = 0;
private int j = 0;
@Override
public void run() {
synchronized (this) {
++i;
try {
// 模拟耗时操作
TimeUnit.SECONDS.sleep(5);
} catch (InterruptedException e) {
e.printStackTrace();
}
++j;
}
}
public void print() {
System.out.println("i=" + i + " j=" + j);
}
}
}
```
### 【简单】一个线程两次调用 `Thread.start()` 方法会怎样?⭐⭐⭐
Java 的线程是不允许启动两次的,**第二次调用 `Thread.start()` 会抛出 `IllegalThreadStateException`**。
### 【简单】`Thread.sleep()`、`Thread.yield()`、`Thread.join()`、`Object.wait()` 有什么区别?⭐⭐⭐⭐
| 方法 | 所属类 | 作用 | 是否释放锁 | 使用场景 |
| --------------------------- | -------- | -------------------------------------------------------- | ----------- | ------------------------------------------ |
| **`Thread.sleep(long ms)`** | `Thread` | **让当前线程暂停执行指定时间**(不释放 CPU 资源) | ❌ 不释放锁 | 模拟耗时操作、定时任务 |
| **`Thread.yield()`** | `Thread` | **提示调度器让出 CPU,但可能立即重新竞争**(不保证让出) | ❌ 不释放锁 | 优化线程调度,减少竞争(极少使用) |
| **`Thread.join()`** | `Thread` | **等待目标线程执行完毕**(阻塞当前线程) | ❌ 不释放锁 | 线程顺序执行,如主线程等待子线程结束 |
| **`Object.wait()`** | `Object` | **释放锁并进入等待,直到 `notify()`/`notifyAll()` 唤醒** | ✔️ 释放锁 | 线程间通信(需在 `synchronized` 块中使用) |

**锁的释放**
- `wait()` 会释放锁,其他方法不会。
- `sleep()` 和 `yield()` 仅影响线程调度,不涉及锁。
**唤醒机制**
- `wait()` 需依赖 `notify()`/`notifyAll()` 或超时唤醒。
- `sleep()` 和 `join()` 超时后自动恢复。
- `yield()` 立刻重新参与竞争。
**用途**
- `sleep()`:固定时间暂停(如定时任务)。
- `yield()`:礼貌让出 CPU(实际开发很少用)。
- `join()`:线程依赖(如主线程等待子线程)。
- `wait()`:线程间协作(生产者-消费者模型)。
> 👉 扩展阅读:[Java 并发编程:线程间协作的两种方式:wait、notify、notifyAll 和 Condition](http://www.cnblogs.com/dolphin0520/p/3920385.html)
### 【中等】为什么 `Thread.sleep()`、`Thread.yield()` 设计为静态方法?⭐⭐
`Thread.sleep()`、`Thread.yield()` 针对的是 **Running** 状态的线程,也就是说在非 **Running** 状态的线程上执行这两个方法没有意义。这就是为什么这两个方法被设计为静态的。它们只针对正在 **Running** 状态的线程工作,避免程序员错误的认为可以在其他非 **Running** 状态线程上调用。
> 👉 扩展阅读:[Java 线程中 yield 与 join 方法的区别](http://www.importnew.com/14958.html)
> 👉 扩展阅读:[sleep(),wait(),yield() 和 join() 方法的区别](https://blog.csdn.net/xiangwanpeng/article/details/54972952)
### 【中等】为什么 `Object.wait()`、`Object.notify()` 和 `Object.notifyAll()` 被定义在 `Object` 类里?⭐⭐⭐
**因为锁是对象的,`wait()`/`notify()` 是锁的行为,所以必须定义在 `Object` 中**。
- **锁基于对象**:Java 的锁(`synchronized`)是 **对象级别** 的,每个对象关联一个监视器(Monitor),`wait()`/`notify()` 是监视器的核心操作,必须属于 `Object`。
- **任何对象都可作为锁**:不仅 `Thread` 能作为锁,**所有对象** 都能作为锁,因此这些方法需定义在 `Object` 以保证通用性。
- **等待队列绑定对象**:调用 `wait()` 的线程会进入 **该对象的等待队列**,`notify()` 唤醒的也是同一对象队列中的线程,与对象强绑定。
- **与 `Thread` 类职责分离**:`Thread` 类管理线程生命周期(如 `sleep()`、`join()`),而 `wait()`/`notify()` 是 **线程间协作机制**,属于锁(对象)的行为。
- **设计一致性与历史原因**:遵循 **Monitor 模式**(操作系统同步原语),保持 `Thread` 简洁,避免功能混淆(如 `wait()` 和 `sleep()` 的误用)。

### 【中等】为什么 `Object.wait()`、`Object.notify()` 和 `Object.notifyAll()` 必须在 `synchronized` 方法/块中被调用?⭐⭐⭐
当一个线程需要调用对象的 `wait()` 方法的时候,这个线程必须拥有该对象的锁,接着它就会释放这个对象锁并进入等待状态直到其他线程调用这个对象上的 `notify()` 方法。同样的,当一个线程需要调用对象的 `notify()` 方法时,它会释放这个对象的锁,以便其他在等待的线程就可以得到这个对象锁。
由于所有的这些方法都需要线程持有对象的锁,这样就只能通过 `synchronized` 来实现,所以他们只能在 `synchronized` 方法/块中被调用。
### 【中等】使用 `volatile` 标记方式停止线程正确吗?⭐⭐⭐
使用 `volatile` 标记方式仅适用于简单场景(无阻塞、无锁竞争)。**推荐 `Thread.interrupt` 和 `Thread.isInterrupted` 方式停止线程**:更通用,可处理阻塞操作,是 Java 线程停止的标准方式。
**`volatile` 标记停止线程适用场景(正确使用)**
- ✔️ **非阻塞循环**
- 线程在 `while (!stopped)` 循环中运行,且 **无阻塞操作**(如 `sleep()`、`wait()`、I/O)。
- `volatile` 保证标志位 (`stopped`) 的修改对所有线程 **立即可见**。
- ✔️ **短周期任务**:适用于 **纯计算型任务** 或 **高频检查标志位** 的场景。
**`volatile` 标记停止线程不适用场景(可能失效)**
- ❌ **线程被阻塞**(如 `sleep()`、`wait()`、I/O):阻塞期间无法检测 `volatile` 标志位,必须等阻塞结束才能退出。
- ❌ **依赖外部资源**(如锁竞争、网络请求):即使 `stopped=true`,线程可能因锁或 I/O 阻塞无法立即退出。
当我们使用 `volatile` 变量来控制线程的停止,通常是通过设置一个 `volatile` 标志位来告诉线程停止执行。例如:
```java
public class MyTask extends Thread {
private volatile boolean canceled = false;
public void run() {
while (!canceled) {
// 执行任务
}
}
public void stopTask() {
canceled = true;
}
}
```
在上述例子中,`canceled` 是一个 `volatile` 变量,用来控制线程的停止。虽然这种方式在某些情况下可以工作,但它并不是一个可靠的停止线程的方式,因为**在多线程环境中,其他线程修改 `canceled` 的值时,可能会出现竞态条件,导致线程无法正确停止**。
### 【中等】Java 线程之间如何进行通信?⭐⭐⭐⭐
在 Java 中,线程间通信(Inter-Thread Communication, ITC)是指多个线程之间协调工作、共享数据或传递消息的机制。常见的线程通信方式包括以下几种:
| 通信方式 | 核心机制 | 适用场景 | 特点 |
| ----------------------- | ------------------------- | ---------------- | -------------- |
| **共享变量** | `volatile`/`synchronized` | 简单状态标记 | 需处理竞态条件 |
| **`wait()`/`notify()`** | 对象监视器 | 生产者-消费者 | 需手动同步 |
| **`BlockingQueue`** | 内置锁和条件队列 | 生产者-消费者 | 无需手动同步 |
| **`CountDownLatch`** | 计数器 | 主线程等待子线程 | 一次性 |
| **`CyclicBarrier`** | 屏障 | 多线程同步 | 可重复使用 |
| **`Semaphore`** | 许可证 | 限流/资源池 | 控制并发数 |
| **管道流** | 字节流 | 线程间数据传输 | 效率较低 |
**推荐选择**:
- 需要高效数据交换 → **`BlockingQueue`**
- 线程协作 → **`wait()`/`notify()` 或 `CountDownLatch`**
- 资源控制 → **`Semaphore`**
- 避免重复造轮子,优先使用 JUC(`java.util.concurrent`)工具类!
### 【简单】高优先级的 Java 线程一定先执行吗?⭐⭐
Java 中的线程优先级的范围是 `[1,10]`,一般来说,高优先级的线程在运行时会具有优先权。可以通过 `thread.setPriority(Thread.MAX_PRIORITY)` 的方式设置,默认优先级为 `5`。
即使设置了线程的优先级,也**无法保证高优先级的线程一定先执行**。这是因为 **Java 线程优先级依赖于操作系统的支持**,然而,不同的操作系统支持的线程优先级并不相同,不能很好的和 Java 中线程优先级一一对应。因此,Java 线程优先级控制并不可靠。
### 【中等】什么是守护线程?用户线程和守护线程有什么区别?⭐⭐⭐
**守护线程(Daemon Thread)** 是一种特殊的线程,其作用是**为其他线程(用户线程)提供服务**。当所有用户线程都结束时,JVM 不会等待守护线程完成,会直接退出。
**用户线程和守护线程的区别**:
| **对比维度** | **用户线程(User Thread)** | **守护线程(Daemon Thread)** |
| ---------------- | ---------------------------------- | ------------------------------------------------------- |
| **JVM 退出行为** | JVM 会等待所有用户线程结束后才退出 | JVM 不等待守护线程结束,所有用户线程结束时 JVM 直接退出 |
| **典型应用** | 业务线程(如处理请求、计算任务) | GC 线程、JIT 编译线程、心跳检测、后台监控 |
| **设置方式** | 默认创建的线程为用户线程 | `thread.setDaemon(true)`(必须在 `start()` 前设置) |
| **继承性** | 子线程默认继承父线程的守护属性 | 守护线程创建的子线程默认也是守护线程 |
| **finally 执行** | 正常执行 | JVM 退出时可能不执行 finally 块 |
**注意事项**:
- **必须在 `start()` 前设置**:否则抛出 `IllegalThreadStateException`。
- **避免在守护线程中执行 I/O/资源清理**:因为 JVM 退出时守护线程可能被强行终止,导致资源未正确释放。
- **线程池的守护属性**:线程池中的线程默认继承创建线程的守护属性,需注意线程池场景下 `finally` 可能不执行。
```java
Thread daemonThread = new Thread(() -> {
while (true) {
// 后台监控逻辑
}
});
daemonThread.setDaemon(true); // 必须在 start() 前设置
daemonThread.start();
```
### 【中等】什么是 FutureTask?它的原理是什么?⭐⭐⭐
`FutureTask` 是 Java 中 `Future` 接口的标准实现,同时实现了 `Runnable` 接口,因此**既可以作为任务提交给线程池执行,又可以异步获取执行结果**。
**FutureTask 的核心状态**:
```java
private volatile int state;
private static final int NEW = 0; // 新建,尚未执行
private static final int COMPLETING = 1; // 正在完成(结果已设置但未发布)
private static final int NORMAL = 2; // 正常完成
private static final int EXCEPTIONAL = 3; // 异常完成
private static final int CANCELLED = 4; // 已取消
private static final int INTERRUPTING = 5; // 正在中断
private static final int INTERRUPTED = 6; // 已中断
```
**核心机制**:
1. **基于 AQS 实现**:`FutureTask` 内部维护一个单向链表等待队列,`get()` 时若任务未完成,线程会被挂起(`LockSupport.park`),任务完成后唤醒所有等待线程。
2. **CAS 保证状态转换原子性**:所有状态变更(完成、取消、异常)通过 CAS 操作完成。
3. **结果可见性**:`state` 为 `volatile`,配合 CAS 保证结果对等待线程可见。
**典型用法**:
```java
FutureTask futureTask = new FutureTask<>(() -> {
Thread.sleep(1000);
return "result";
});
new Thread(futureTask).start(); // 或 executor.submit(futureTask)
String result = futureTask.get(); // 阻塞直到任务完成
```
**FutureTask vs CompletableFuture**:
| 特性 | `FutureTask` | `CompletableFuture` |
| ------------ | ---------------------- | ------------------------------- |
| **链式编排** | 不支持 | 支持(thenApply/thenAccept 等) |
| **异常处理** | 只能 get 时抛出 | 支持 exceptionally/handle |
| **组合操作** | 不支持 | 支持 allOf/anyOf |
| **手动完成** | 支持 complete | 支持 complete |
| **回调机制** | 不支持(只能阻塞轮询) | 支持(任务完成自动触发回调) |